Ein Werksleiter benötigt einen zuverlässigen Überblick über Lagerbestände, Produktionsverzögerungen, Lieferantenleistung und Wartungsrisiken. Die Finanzabteilung benötigt dieselben Daten, um sie mit dem ERP-System abzugleichen. Der Kundenservice benötigt den aktuellen Auftragsstatus, ohne ein Ticket an die IT-Abteilung senden zu müssen. Hier wird die Entscheidung zwischen Data Fabric und Data Mesh relevant: Sie bestimmt, wie schnell vertrauenswürdige Daten die Arbeit im gesamten Unternehmen unterstützen können und wer die Verantwortung trägt, wenn dies nicht der Fall ist.
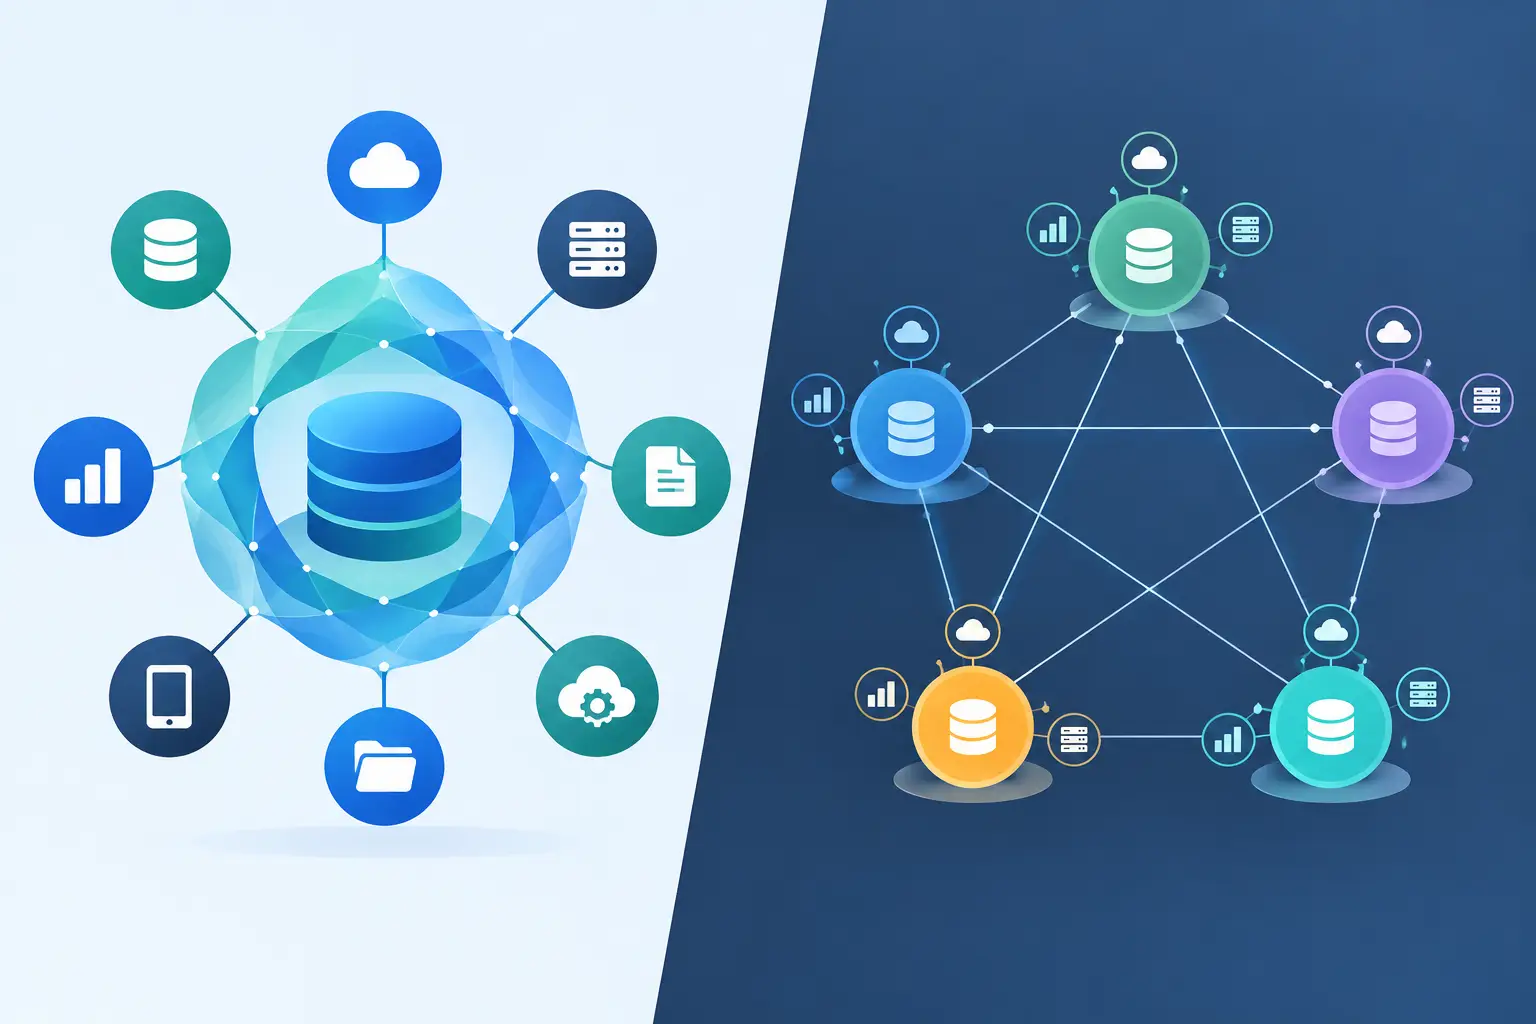
Keiner der beiden Ansätze ist ein Softwareprodukt oder eine Abkürzung für mangelhaftes Datenmanagement. Beide können den Datenzugriff in fragmentierten Systemen verbessern. Der Unterschied liegt im Betriebsmodell. Ein Data Fabric betont die vernetzte, automatisierte Datenverwaltung im gesamten Unternehmen. Ein Data Mesh verteilt die Verantwortung für Datenprodukte auf die Geschäftsbereiche, die die Daten erstellen und verstehen.
Für betriebsintensive Unternehmen hängt die richtige Wahl weniger von der Marktterminologie ab, sondern vielmehr von der Prozessreife, der Governance-Kapazität, der Systemkomplexität und den Geschäftsergebnissen, die das Datenprogramm unterstützen muss.
Data Fabric versus Data Mesh: Der Kernunterschied
Eine Dateninfrastruktur ist ein Architekturansatz zur Integration, Verwaltung und Bereitstellung von Daten aus verschiedenen Quellen. Sie nutzt Metadaten, Datenkataloge, Integrationspipelines, semantische Modelle und Automatisierung, um verteilte Daten leichter auffindbar, verständlich und nutzbar zu machen. Ziel ist eine vernetzte Datenschicht, die den Aufwand für den Datenaustausch zwischen ERP-, CRM- und Produktionssystemen, Dokumenten, Cloud-Plattformen und Altanwendungen reduziert.
In der Praxis bietet eine solche Architektur Unternehmensteams oft eine einheitlichere Möglichkeit, Daten zu identifizieren, Qualitätskontrollen durchzuführen, Zugriffe zu verwalten und Informationen für Dashboards, Automatisierungs-Workflows, Analysen und KI-Anwendungsfälle bereitzustellen. Sie ist besonders wertvoll, wenn für dieselbe operative Frage Informationen aus vielen Systemen benötigt werden.
Ein Data Mesh ist ein dezentrales Datenbetriebsmodell. Anstatt Daten von einem zentralen Team sammeln und für alle anderen aufbereiten zu lassen, werden die Verantwortlichkeiten für die Veröffentlichung nutzbarer Datenprodukte an verschiedene Bereiche delegiert. Der Einkauf ist für Lieferantendaten zuständig, die Fertigung für Produktionsdaten und die Finanzabteilung für Finanzkennzahlen. Jeder Bereich soll Daten bereitstellen, die auffindbar, verständlich, verwaltet und für die Nutzung durch andere geeignet sind.
Das Mesh-Modell basiert auf vier praktischen Ideen: Domänenverantwortung, Daten als Produkt, Self-Service-Dateninfrastruktur und föderierte Governance. Es zielt darauf ab, das zentrale Datenteam als Engpass in der Bereitstellung zu eliminieren, ohne dabei Unternehmensstandards zu beeinträchtigen.
Die Unterscheidung ist wichtig. Ein Fabric beantwortet primär die Frage: „Wie verbinden und verwalten wir unsere verteilten Datenbestände?“ Ein Mesh beantwortet primär die Frage: „Wie verteilen wir die Verantwortung für Datenqualität und -nutzbarkeit im Unternehmensmaßstab?“ Eine ausgereifte Organisation kann beides nutzen.
Wann eine Dateninfrastruktur der bessere Ausgangspunkt ist
Für Unternehmen, die mit fragmentierten Systemen, uneinheitlichen Definitionen und begrenzter Datenhoheit zu kämpfen haben, ist der Aufbau einer Dateninfrastruktur oft der sinnvollste erste Schritt. Diese Bedingungen sind häufig nach Jahren von Akquisitionen, regionalen Prozessunterschieden, ERP-Anpassungen und abteilungsinternen Technologieanschaffungen zu beobachten.
Stellen Sie sich eine Shared-Services-Organisation vor, die große Mengen an Rechnungen, Bestellungen, Reklamationen oder Serviceanfragen verarbeitet. Die zur Automatisierung und Überwachung dieser Prozesse benötigten Informationen können sich über verschiedene Systeme verteilen: ERP-Systeme, Dokumentenablagen, E-Mails, Workflow-Tools, Lieferantenportale und Tabellenkalkulationen. Bevor die Verantwortung für Datenprodukte mehreren Domänen zugewiesen wird, benötigt die Organisation eine zuverlässige Methode, um diese Quellen zu verbinden, gemeinsame Kennungen festzulegen, Definitionen zu dokumentieren und Zugriffskontrollen durchzusetzen.
Eine solche Infrastruktur bildet die Grundlage. Sie reduziert die manuelle Datenaufbereitung, verbessert die Nachvollziehbarkeit von Daten und stellt verlässliche Informationen für gängige Anwendungsfälle wie Betriebskapitalberichte, Ausnahmebehandlung, Prozessanalyse oder KI-gestützte Dokumentenverarbeitung. Zudem hilft sie zentralen Teams, Konflikte in Datensätzen und unvollständige kritische Felder zu identifizieren.
Dies bedeutet nicht, alle Datensätze auf einer einzigen physischen Plattform zu zentralisieren. Eine gut konzipierte Infrastruktur kann Daten dort verbinden, wo sie gespeichert sind, und gleichzeitig einheitliche Metadaten und Governance-Standards gewährleisten. Das ist nützlich für Unternehmen, die Daten aus regulatorischen, betrieblichen oder Kostengründen in bestimmten Systemen speichern müssen.
Der Kompromiss ist organisatorischer Natur. Eine zentral verwaltete Infrastruktur kann zu einer weiteren IT-gesteuerten Service-Warteschlange werden, wenn die Fachabteilungen nicht in die Definition von Datenqualitätsregeln und Prioritäten einbezogen werden. Technologie mag Systeme erfolgreich verbinden, während die operativen Teams sich weiterhin uneinig sind, was „pünktliche Lieferung“, „aktiver Kunde“ oder „verfügbarer Bestand“ bedeuten. Architektur kann eine fehlende Geschäftsentscheidung nicht lösen.
Wann ein Datennetz mehr Wert schaffen kann
Ein Datennetz ist am effektivsten, wenn ein Unternehmen über klar abgegrenzte Geschäftsbereiche mit kompetenten Führungskräften, eindeutigen Verantwortlichkeiten und ausreichendem Umfang verfügt, um eine dezentrale Bereitstellung zu rechtfertigen. Es funktioniert am besten, wenn Daten nicht nur ein IT-Ergebnis, sondern ein verwaltetes Unternehmensgut sind, das mit der operativen Leistung verknüpft ist.
Ein global tätiger Hersteller kann beispielsweise separate, aber voneinander abhängige Bereiche für Entwicklung, Lieferkette, Produktion, Qualitätssicherung, Vertrieb und Kundendienst haben. Jeder Bereich generiert Daten mit spezifischem Kontext. Das Qualitätssicherungsteam versteht Fehlerklassifizierungen. Die Lieferkette versteht Ausnahmen bei den Lieferzeiten der Zulieferer. Die Serviceteams verstehen die installierte Basis und den Garantiestatus. Wenn ein zentrales Team jedes Detail modellieren, jede Frage beantworten und jeden Datensatz veröffentlichen soll, kann dies die Entscheidungsfindung verlangsamen.
In einem vernetzten Modell veröffentlichen diese Domänen Datenprodukte mit dokumentierten Definitionen, Serviceerwartungen, Zuständigkeiten und Qualitätskriterien. Ein Lieferkettendatenprodukt könnte beispielsweise genehmigte Leistungskennzahlen von Lieferanten, die Historie der Lieferzeiten und das aktuelle Lieferrisiko bereitstellen. Finanz- und Betriebsabteilungen können es bedenkenlos nutzen, da Zuständigkeit, Aktualisierungsfrequenz, zulässige Nutzung und Qualitätsschwellenwerte klar definiert sind.
Der Vorteil liegt in der Geschwindigkeit bei gleichzeitiger Nachvollziehbarkeit. Fachexperten pflegen die Daten, die dem Prozess am nächsten sind, während Anwender sie finden und nutzen können, ohne die gleichen Datenextrakte in jeder Abteilung neu erstellen zu müssen.
Der Kompromiss ist beträchtlich. Ein Netzwerk erfordert mehr als die bloße Zuweisung von Verantwortlichen in einer Governance-Präsentation. Domänenteams benötigen Kompetenzen, Kapazitäten, Produktmanagement-Disziplin und gemeinsame technische Standards. Ohne Self-Service-Tools und durchsetzbare Governance kann Dezentralisierung zu mehreren Versionen derselben Metrik, inkonsistenten Sicherheitspraktiken und einer kostspieligen Ansammlung lokaler Pipelines führen.
Ein Datennetz sollte nicht dazu verwendet werden, bestehende Datensilos zu formalisieren. Wenn jede Domäne Daten in ihrem eigenen Format und Vokabular veröffentlicht, entsteht im Unternehmen verteilte Fragmentierung statt verteilter Wertschöpfung.
Architektur und Eigentumsverhältnisse müssen zusammenarbeiten
Die sinnvollste Entscheidung ist selten die zwischen Data Fabric und Data Mesh als sich gegenseitig ausschließenden Optionen. Die Funktionen einer Data Fabric können die Infrastruktur und Governance-Ebene bereitstellen, die ein Mesh praktikabel macht. Ein Mesh-Betriebsmodell kann die unternehmerische Verantwortung gewährleisten und so verhindern, dass eine Fabric zu einer technisch eleganten, aber schlecht genutzten Plattform wird.
Dieser kombinierte Ansatz ist besonders relevant, wenn Unternehmen Automatisierung und KI skalieren möchten. Ein intelligentes Automatisierungsprogramm benötigt mehr als nur Zugriff auf Quelldaten. Es braucht klare Definitionen, zuverlässige Datensätze, genehmigte Zugriffsrechte, nachvollziehbare Transformationen und Prozessverantwortliche, die auf Ausnahmen reagieren können. GenAI-Anwendungen stellen eine weitere Anforderung: Sie müssen Informationen aus autorisierten, aktuellen und gut klassifizierten Quellen und nicht aus unkontrollierten Dokumentensammlungen beziehen.
Ein praxisorientiertes Modell könnte gängige Funktionen wie Identitäts- und Zugriffsmanagement, Metadatenmanagement, Stammdatenregeln, Integrationsstandards, Observability und die semantische Schicht zentralisieren. Die Geschäftsbereiche sind dann für die Qualität und den Lebenszyklus der Datenprodukte verantwortlich, die am engsten mit ihren Prozessen verknüpft sind. Zentrale Standards bleiben unverändert, während die Verantwortlichkeit dort liegt, wo operatives Wissen vorhanden ist.
Diese Struktur unterstützt auch messbare Ergebnisse. Anstatt das Programm anhand der Anzahl der erfassten Datensätze oder veröffentlichten Dashboards zu beurteilen, sollten Ergebnisse wie weniger manuelle Abstimmungen, schnellere Monatsabschlüsse, niedrigere Quoten von Rechnungsabweichungen, kürzere Auftragsabwicklungszeiten oder schnellere Reaktion auf Produktionsstörungen definiert werden.
Wie man die Entscheidung trifft, ohne ein weiteres Plattformprogramm zu starten
Beginnen Sie mit Geschäftsprozessen, nicht mit Architekturskizzen. Identifizieren Sie die funktionsübergreifenden Prozesse, in denen fehlerhafte Daten zu Verzögerungen, Nacharbeiten, Risiken oder Umsatzeinbußen führen. Bei einem Hersteller können dies beispielsweise die Planungs- und Prognoseprozesse, die Beschaffungs- und Zahlungsprozesse oder das Qualitätsmanagement sein. Bei einem Gesundheitsdienstleister könnten es das Überweisungsmanagement, die Leistungsabrechnung oder die Kapazitätsplanung sein.
Bewerten Sie anschließend die bestehende Grundlage. Können die Teams die maßgebliche Datenquelle für wichtige Entitäten identifizieren? Sind Geschäftsdefinitionen vereinbart? Ist die Herkunft kritischer Berichte nachvollziehbar? Können autorisierte Benutzer ohne wiederholte manuelle Datenextraktion auf Informationen zugreifen? Lautet die Antwort größtenteils „Nein“, haben die Infrastruktur und die zentrale Datenverwaltung wahrscheinlich Priorität.
Als Nächstes sollte die organisatorische Bereitschaft für verteilte Verantwortung geprüft werden. Gibt es in den einzelnen Bereichen benannte Verantwortliche, die Entscheidungen zur Datenqualität treffen können? Können Mitarbeiter für die Pflege der Datenprodukte abgestellt werden? Sind die Leistungskennzahlen so aufeinander abgestimmt, dass Teams vom Informationsaustausch profitieren, anstatt Informationen zu schützen? Falls nicht, wird eine flächendeckende Einführung zu Verpflichtungen führen, die die Organisation nicht erfüllen kann.
Ein schrittweises Vorgehen ist in der Regel effektiver als eine grundlegende Neugestaltung. Wählen Sie einen wichtigen Prozess mit klaren Verantwortlichen und messbaren Problemen. Definieren Sie die Prozesse, legen Sie die Datenqualitätsregeln, das Zugriffsmodell und die Anforderungen an die Bereitstellung fest. Entwickeln Sie die notwendigen Integrations- und Metadatenfunktionen. Weisen Sie anschließend die Verantwortlichkeiten entsprechend dem tatsächlichen Geschäftswissen und den Entscheidungsbefugnissen zu.
Ective betrachtet diese Arbeit als eine ausführende Disziplin: Prozessneugestaltung, Datenarchitektur, Governance, Automatisierung und Messung müssen sich gegenseitig verstärken. Ein Datenmodell, das vom operativen Prozess abgekoppelt ist, wird unabhängig von der zugrunde liegenden Plattform keine nachhaltigen Verbesserungen erzielen.
Entwickeln Sie für Entscheidungen, nicht für Datenmengen
Die stärkste Datenstrategie ist diejenige, die Führungskräften hilft, bessere Entscheidungen zu treffen, bevor das operative Zeitfenster schließt. Für manche Unternehmen beginnt dies mit einer Dateninfrastruktur, die Ordnung in eine komplexe IT-Landschaft bringt. Für andere bedeutet es, kompetenten Fachbereichen über ein vernetztes Modell die Verantwortung für Datenprodukte zu übertragen. Für viele bedeutet es, die gemeinsame Grundlage einer solchen Infrastruktur zu schaffen und schrittweise eine vernetzte Verantwortungsstruktur zu etablieren, die einen klaren Mehrwert für das Unternehmen bietet.
Wählen Sie das Modell, das Ihre Organisation steuern, betreiben und messen kann. Beweisen Sie es anschließend in den Prozessen, in denen verlässliche Daten den Arbeitsalltag erleichtern.