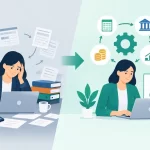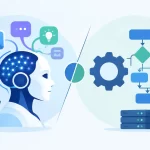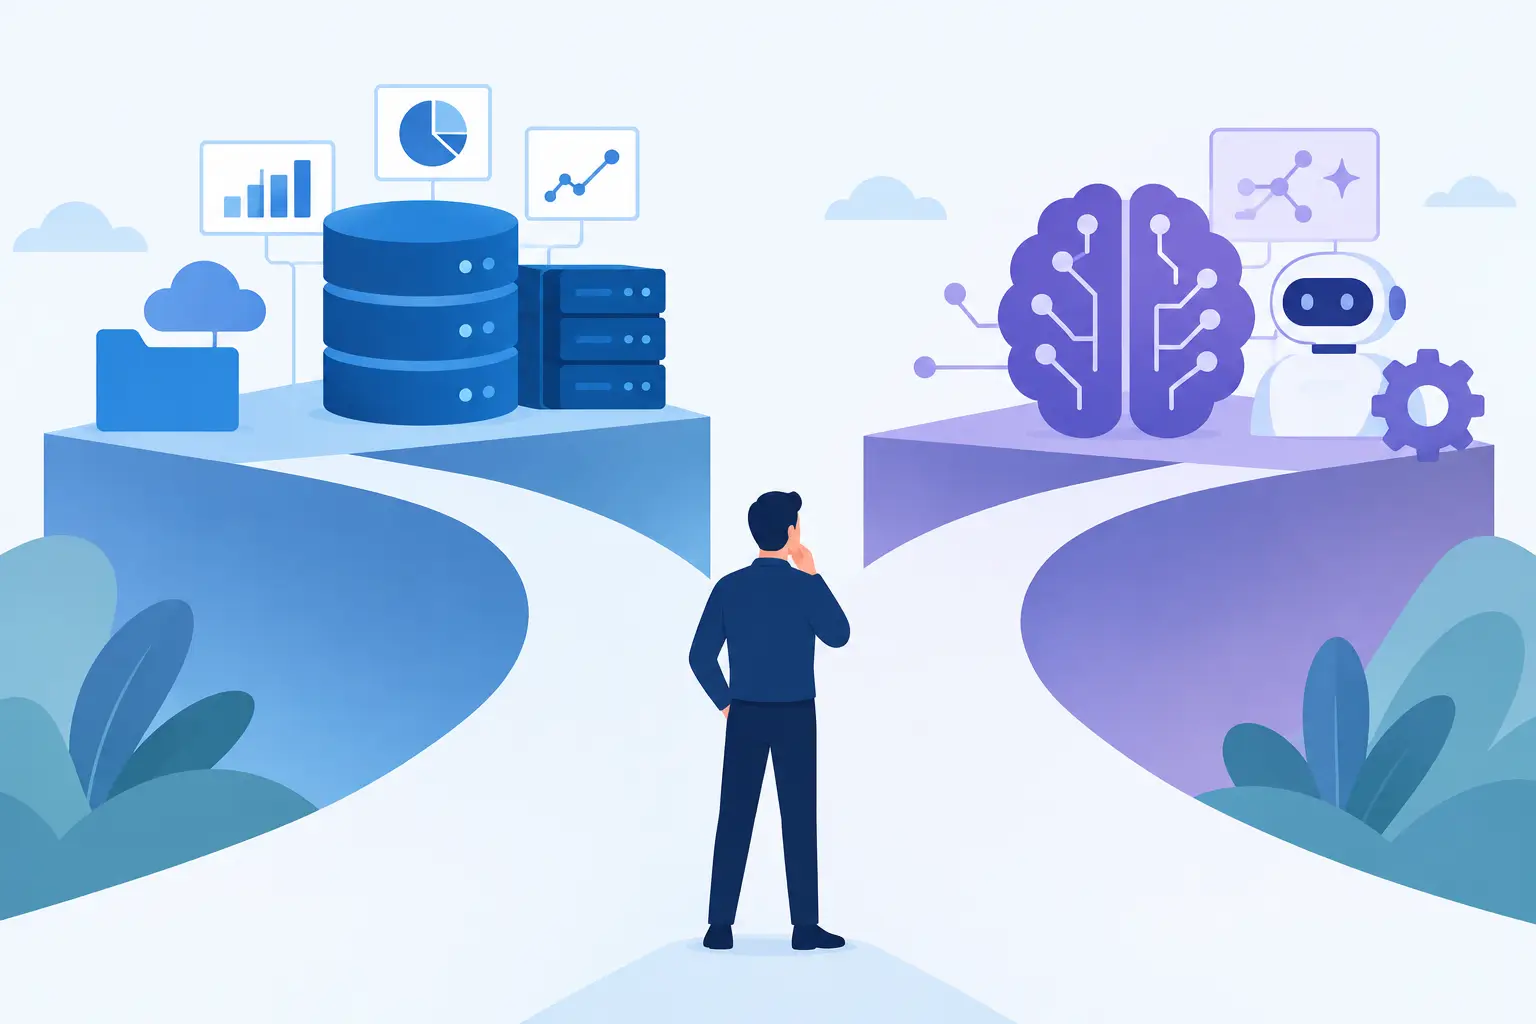
Un responsable d'usine se demande pourquoi un copilote IA ne peut pas générer un rapport fiable sur les anomalies de production. La réponse réside rarement dans le modèle lui-même. Le statut des commandes est stocké dans un système, les données d'inventaire dans un autre, les interventions de maintenance sont signalées tardivement et les équipes utilisent des définitions différentes des temps d'arrêt. C'est là le problème pratique qui sous-tend l'opposition entre la base de données et la mise en œuvre de l'IA : une entreprise ne peut automatiser ou améliorer ses décisions de manière cohérente si ses processus et données sous-jacents sont incohérents.
Pour les organisations fortement axées sur les opérations, il ne s'agit pas d'un argument contre l'IA, mais d'un plaidoyer pour une planification rigoureuse des projets de transformation, afin que les investissements en IA améliorent la performance plutôt que d'ajouter une couche supplémentaire et déconnectée à l'architecture technologique.
Base de données vs implémentation de l'IA : le vrai choix
La mauvaise question est : « Faut-il investir dans les données ou dans l’IA ? » La plupart des entreprises ont besoin des deux. La question pertinente est : quelles sont les contraintes qui empêchent actuellement de prendre de meilleures décisions, d’accélérer l’exécution et de mettre en place une automatisation à grande échelle ?
Une infrastructure de données constitue le socle opérationnel qui rend l'information exploitable par les personnes, les processus et les systèmes. Elle comprend des données métier définies, la propriété des données, des contrôles qualité, des modèles d'intégration, des règles d'accès et l'architecture nécessaire pour garantir la disponibilité d'informations fiables lors des opérations. Elle requiert également un consensus sur le processus de génération des données. Si un bon de commande est transmis par e-mail, tableurs et exceptions non suivies, une plateforme de données seule ne suffira pas à lever l'ambiguïté.
L'intégration de l'IA applique l'apprentissage automatique, l'IA générative, l'analyse documentaire ou les capacités d'aide à la décision à un objectif commercial précis. Elle peut, par exemple, classer des factures, synthétiser des demandes de service, prédire des pannes d'équipement, guider les employés dans leurs procédures ou identifier des transactions inhabituelles. Ces cas d'usage peuvent générer des gains significatifs, mais leurs résultats dépendent de la qualité, de l'exhaustivité et du contexte des données d'entrée.
Cette distinction est importante car l'IA peut donner des résultats impressionnants à partir d'un ensemble de données limité, tout en se révélant inefficace au quotidien. Une solution performante pour une unité commerciale peut devenir peu fiable lorsqu'elle est déployée auprès de plusieurs entités juridiques, instances ERP, langues, règles d'approbation et procédures de gestion des exceptions.
Pourquoi le processus prime sur les deux
Les données d'entreprise ne sont pas créées ex nihilo. Elles sont produites par des flux de travail : un agent du service client met à jour un dossier, un planificateur modifie un planning, une équipe d'entrepôt confirme une réception ou le service financier résout un problème. Lorsque ces flux de travail sont flous, non standardisés ou fortement manuels, les données qui en résultent présentent les mêmes faiblesses.
C’est pourquoi la transformation doit commencer par un examen du processus de bout en bout. Il convient d’identifier l’origine des transactions, les lieux de prise de décision, les exceptions nécessitant un jugement et les étapes de ressaisie ou de rapprochement des informations par les employés. Ensuite, il faut définir le processus cible et les données nécessaires à son fonctionnement.
Prenons l'exemple de la comptabilité fournisseurs. Une entreprise peut souhaiter utiliser l'IA générative pour répondre aux demandes des fournisseurs et extraire les données des factures à partir des documents. Ces fonctionnalités peuvent s'avérer utiles, mais pas si les données de base des fournisseurs sont dupliquées, si le statut des paiements est retardé d'un système à l'autre et si les motifs d'exception sont des notes en texte libre sans catégorisation cohérente. Il est donc urgent de standardiser la saisie des données, de définir des codes d'exception, de connecter les systèmes concernés et d'attribuer les données fournisseurs. L'IA disposera alors d'un processus stable pour s'appuyer sur ces données.
Cette approche permet également d'éviter un écueil fréquent : l'automatisation accélérée d'un processus défaillant. Accélérer le traitement des approbations ambiguës ou l'intégration plus rapide dans un flux de travail incontrôlé n'améliore pas l'efficacité. Au contraire, cela accroît le volume de travail nécessitant encore des corrections.
À quoi ressemble une base de données utilisable ?
Une infrastructure de données ne nécessite pas un programme pluriannuel avant de générer de la valeur ajoutée pour l'entreprise. Elle requiert un périmètre d'action précis, aligné sur les processus prioritaires. L'objectif n'est pas de centraliser l'intégralité des données disponibles, mais de garantir la fiabilité, la disponibilité et la gouvernance des données nécessaires à une décision opérationnelle stratégique.
Pour chaque cas d'usage, les responsables doivent définir un produit de données clair : l'ensemble des informations, indicateurs, responsabilités, exigences de qualité et règles d'accès dont dépend une équipe ou un processus d'automatisation. Par exemple, un produit de données de traitement des commandes peut combiner les lignes de commande, les stocks disponibles, le statut des expéditions, la priorité du client et les motifs d'exception. Chaque champ doit avoir une définition convenue et un responsable désigné.
Une base pratique prend également en compte l'intégration et la synchronisation. Un tableau de bord basé sur les données de la veille peut suffire à la planification mensuelle des capacités, mais s'avérer insuffisant pour la récupération des commandes du jour même. De même, un assistant IA qui recommande les actions à entreprendre doit avoir accès aux documents de politique en vigueur, à l'état actuel des transactions et au contexte client ou actif pertinent. L'architecture doit refléter la rapidité et la fiabilité requises par le processus métier, et non une préférence technologique générique.
La gouvernance est tout aussi opérationnelle. Elle implique que l'on puisse répondre à des questions simples mais cruciales : À qui appartient ce champ ? Que se passe-t-il en cas d'échec de la validation ? Quel est le système source de référence ? Qui est autorisé à utiliser ces données pour un cas d'usage d'IA ? Comment les informations sensibles sont-elles protégées ? Ces contrôles réduisent la charge de maintenance qui apparaît souvent après la réussite d'un projet pilote initial.
Quand l'IA peut démarrer avant même que les fondations ne soient achevées
Le principe de « privilégier les fondations » ne doit pas servir de prétexte pour retarder indéfiniment des travaux utiles. Certaines initiatives en IA peuvent démarrer rapidement lorsque le processus est bien délimité, les risques maîtrisables et les données d'entrée contrôlées.
Un assistant de connaissances pour les politiques internes peut constituer un cas d'usage initial judicieux s'il s'appuie sur des documents approuvés, dispose d'autorisations clairement définies et oriente les employés vers les sources documentaires en cas de doute. La classification des documents est également pertinente lorsque les types de documents sont limités et que des humains examinent les résultats incertains. Ces projets aident les équipes à mettre en place des pratiques d'adoption, de gouvernance et d'évaluation, parallèlement à l'amélioration continue des données à plus grande échelle.
Le compromis réside dans la portée. Les premiers projets d'IA ne devraient pas prendre de décisions à fort impact sans données fiables, traçabilité et procédures d'escalade. Un assistant peut rédiger une réponse à un fournisseur, mais ne devrait pas modifier automatiquement les conditions de paiement sur la base d'informations incomplètes. Un modèle de prévision peut signaler des problèmes de stock potentiels, mais ne devrait pas remplacer le jugement en matière de planification tant que ses performances n'ont pas été testées en conditions normales, en périodes de pointe et dans des cas particuliers.
Le bon ordre d'exécution dépend de quatre conditions :
- Le processus métier a un responsable défini et un résultat mesurable.
- Les données requises sont disponibles avec une qualité suffisante pour la prise de décision envisagée.
- Les exceptions peuvent être acheminées vers une personne ou un flux de travail contrôlé.
- Les exigences en matière de sécurité, d'accès et de responsabilité sont claires.
Si ces conditions sont remplies, un cas d'utilisation de l'IA peut apporter de la valeur tout en révélant précisément les points à améliorer au niveau des données de base.
Mesurez le résultat commercial, pas l'activité modèle
Les programmes de mise en œuvre de l'IA communiquent souvent des indicateurs d'activité : utilisateurs activés, requêtes soumises, documents traités ou modèles déployés. Ces indicateurs témoignent de l'adoption, mais ne permettent pas d'établir la valeur opérationnelle.
Les dirigeants d'entreprise doivent relier chaque initiative à des indicateurs de processus. En finance, cela peut concerner le taux de traitement automatisé, le délai de résolution des exceptions, le coût par facture ou le respect des délais de paiement. Dans le service client, il peut s'agir de la résolution au premier contact, du temps de traitement, du volume d'affaires en attente et du respect des niveaux de service. En production, les indicateurs pertinents peuvent inclure la stabilité des plannings, les temps d'arrêt non planifiés, les rebuts et le délai de résolution des problèmes qualité.
Il est essentiel d'établir une base de référence. Sans cela, une équipe ne peut distinguer un gain réel des fluctuations saisonnières de volume, des changements de personnel ou des solutions de contournement temporaires. Cette base de référence doit également suivre les indicateurs de qualité parallèlement à la rapidité. Un processus de classification plus rapide qui génère davantage d'erreurs en aval ne constitue pas un gain de productivité.
C’est là que la mise en œuvre intégrée prend tout son sens. La refonte des processus, la gestion des données, l’automatisation, l’IA, les tableaux de bord et la gestion du changement doivent se renforcer mutuellement. Lorsque différents fournisseurs sont responsables de chaque couche sans modèle opérationnel partagé, les entreprises héritent souvent d’une responsabilité fragmentée et de transferts de responsabilité coûteux. Une feuille de route de transformation unique permet de visualiser les dépendances et d’aider les équipes à prioriser les tâches qui produisent des résultats mesurables.
Une séquence pratique pour les dirigeants d'entreprise
Commencez par un ou deux processus où le volume de transactions, l'effort manuel, les délais de décision ou le risque de non-conformité sont élevés. Cartographiez le flux de travail actuel à travers les fonctions et les systèmes. Quantifiez les reprises, les temps d'attente, le volume d'exceptions et le coût d'une visibilité insuffisante.
Ensuite, définissez le processus opérationnel cible et les données nécessaires à sa gestion. Standardisez les définitions, attribuez les responsabilités et connectez les systèmes contenant les enregistrements pertinents. Automatisez les étapes prévisibles lorsque les règles sont stables. Cela génère souvent une valeur ajoutée immédiate avant même l'introduction d'une IA avancée.
Ensuite, appliquez l'IA là où elle améliore une décision, une interaction ou une tâche de traitement de données non structurées. Prévoyez une validation humaine lorsque le risque ou l'incertitude est élevé et suivez les résultats après le déploiement. N'étendez le système qu'après que la première implémentation ait démontré la qualité, la gouvernance et la rentabilité en conditions réelles d'exploitation.
Ective aborde cette séquence comme une discipline d'exécution : organiser le flux de travail, structurer les données, automatiser les tâches répétitives et appliquer l'IA là où elle améliore sensiblement les performances. Il ne s'agit pas d'un projet pilote isolé, mais d'une capacité opérationnelle déployable à l'échelle de différentes fonctions et unités commerciales.
Les programmes d'IA les plus performants ne débutent pas par une simple sélection de modèle. Ils s'appuient sur un processus métier qui mérite d'être optimisé, des données fiables pour étayer une décision éclairée et une définition claire des critères de performance. En partant de ces bases, chaque investissement ultérieur en IA a bien plus de chances de s'intégrer aux opérations quotidiennes plutôt que de rester une simple démonstration prometteuse.