Un responsabile di stabilimento chiede perché un assistente virtuale basato sull'IA non sia in grado di generare un report affidabile sulle anomalie di produzione. La risposta raramente risiede nel modello. Lo stato degli ordini si trova in un sistema, i dati di inventario in un altro, gli interventi di manutenzione arrivano in ritardo e i team utilizzano definizioni diverse di tempo di inattività. Questo è il problema pratico che si cela dietro la una solida base di dati e l'implementazione dell'IA: un'azienda non può automatizzare o potenziare i processi decisionali in modo coerente quando i processi e i dati sottostanti sono incoerenti.
Per le organizzazioni fortemente orientate alle operazioni, questo non è un argomento contro l'IA. È piuttosto un argomento a favore di una sequenza di trasformazione tale che gli investimenti in IA migliorino le prestazioni, anziché aggiungere un ulteriore livello scollegato allo stack tecnologico.
Fondamenti di dati vs. implementazione dell'IA: la vera decisione
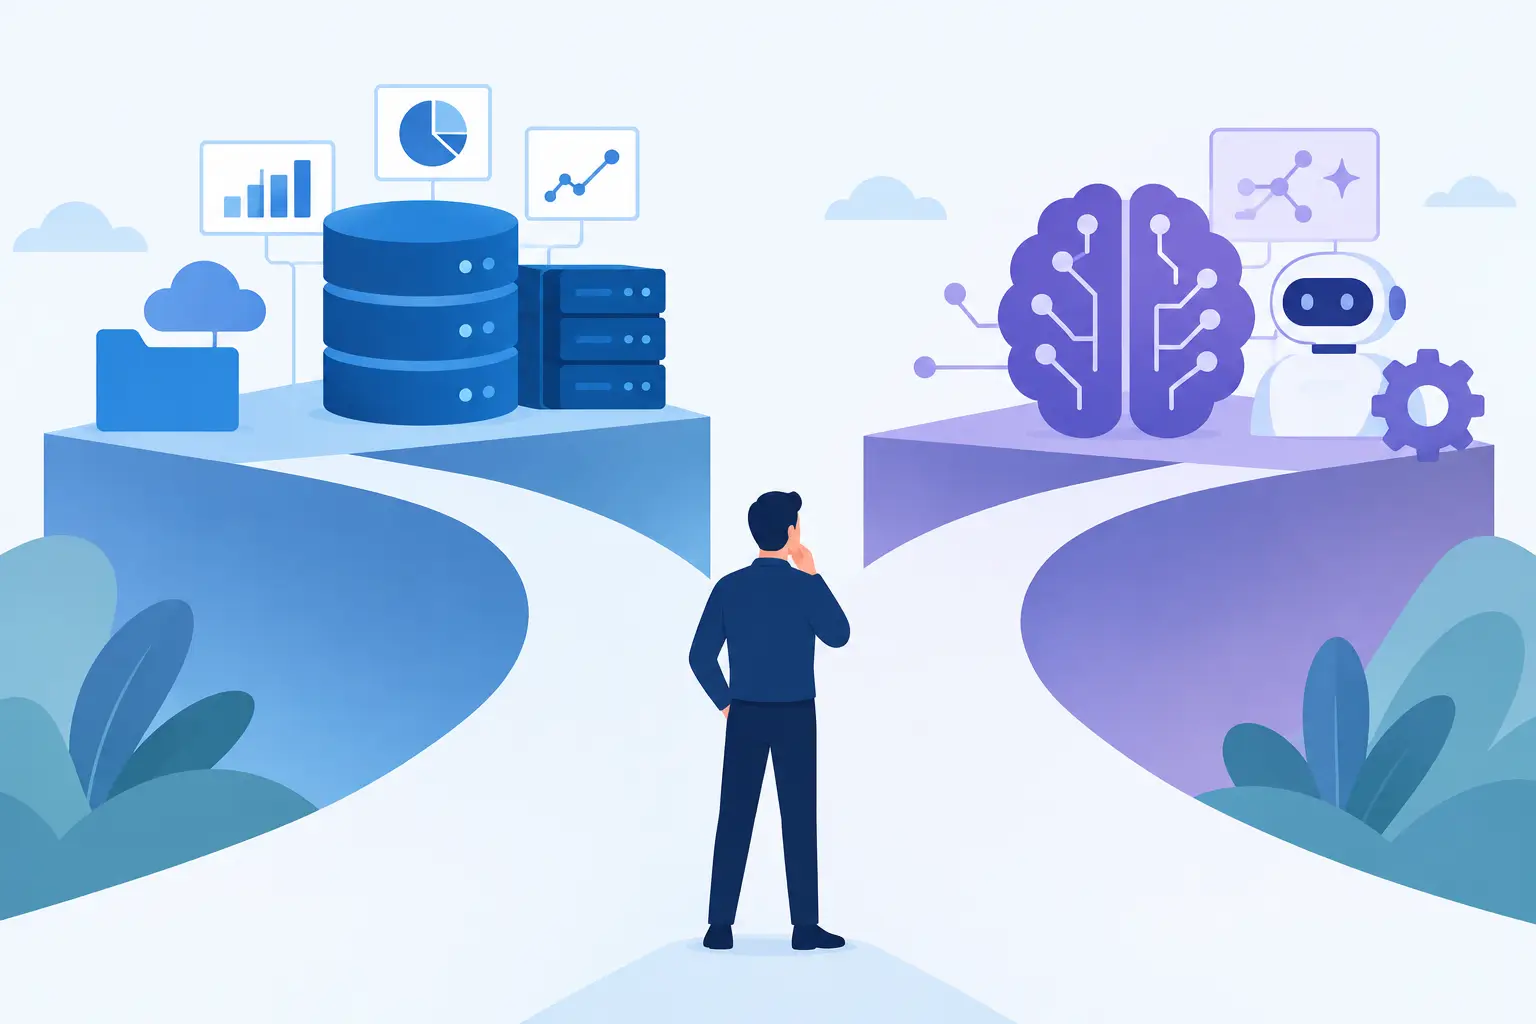
La domanda sbagliata è: "Dovremmo investire nei dati o nell'intelligenza artificiale?". La maggior parte delle aziende ha bisogno di entrambi. La domanda più utile è: quali vincoli impediscono attualmente di prendere decisioni migliori, di accelerare l'esecuzione e di ottenere un'automazione scalabile?
Una base dati è l'infrastruttura operativa che rende le informazioni fruibili da persone, processi e sistemi diversi. Comprende dati aziendali definiti, la proprietà, i controlli di qualità, i modelli di integrazione, le regole di accesso e l'architettura necessaria per rendere disponibili informazioni affidabili quando si lavora. Richiede inoltre un accordo sul processo di generazione dei dati. Se un ordine di acquisto passa di mano tramite e-mail, fogli di calcolo ed eccezioni non tracciate, una piattaforma dati da sola non risolverà l'ambiguità.
L'implementazione dell'IA applica l'apprendimento automatico, l'IA generativa, l'analisi documentale o le funzionalità di supporto alle decisioni a un risultato aziendale definito. Può classificare le fatture, riassumere le richieste di assistenza, prevedere guasti alle apparecchiature, guidare i dipendenti attraverso le procedure o identificare transazioni insolite. Questi casi d'uso possono produrre vantaggi significativi, ma i loro risultati dipendono dalla qualità, dalla completezza e dal contesto degli input ricevuti.
Questa distinzione è importante perché l'IA può creare dimostrazioni impressionanti a partire da un set di dati limitato, fallendo però nelle operazioni quotidiane. Una soluzione che funziona bene per una singola unità aziendale può diventare inaffidabile se applicata a diverse entità legali, istanze ERP, lingue, regole di approvazione e percorsi di eccezione.
Perché il processo viene prima di entrambi
I dati aziendali non vengono creati nel vuoto. Sono il risultato di flussi di lavoro: un addetto all'assistenza clienti aggiorna un caso, un pianificatore modifica un programma, un team di magazzino conferma una ricezione o il reparto finanziario risolve un'eccezione. Quando questi flussi di lavoro non sono chiari, non standardizzati o sono in gran parte manuali, i dati risultanti presenteranno le stesse debolezze.
Ecco perché la trasformazione dovrebbe iniziare con l'esame del processo end-to-end. Identificare l'origine delle transazioni, il luogo in cui vengono prese le decisioni, le eccezioni che richiedono un giudizio e i punti in cui i dipendenti reinseriscono o riconciliano le informazioni. Quindi definire il processo target e i dati necessari per il suo funzionamento.
Consideriamo la contabilità fornitori. Un'organizzazione potrebbe desiderare l'intelligenza artificiale generativa per rispondere alle richieste dei fornitori e per documentare i dati delle fatture. Queste funzionalità possono essere utili, ma non se i dati anagrafici dei fornitori sono duplicati, lo stato dei pagamenti è ritardato tra i diversi sistemi e le motivazioni delle eccezioni sono note in formato testo libero senza categorie coerenti. L'opportunità immediata potrebbe essere quella di standardizzare l'acquisizione dei dati, definire i codici di eccezione, collegare i sistemi pertinenti e stabilire la responsabilità dei dati dei fornitori. L'IA potrà quindi supportare un processo stabile.
Questo approccio previene anche una modalità di errore comune: automatizzare un processo difettoso a una velocità maggiore. Un instradamento più rapido di approvazioni poco chiare o un'estrazione più veloce in un flusso di lavoro non controllato non crea efficienza. Aumenta invece il volume di lavoro che necessita ancora di correzioni.
Come si presenta una base di dati utilizzabile
Una solida base di dati non richiede un programma pluriennale prima che si manifesti un valore aziendale. Richiede invece un ambito di applicazione ben definito e vincolato a processi prioritari. L'obiettivo non è centralizzare ogni singolo record disponibile, bensì rendere i dati necessari per prendere decisioni operative di alto valore affidabili, tempestivi e gestiti in modo appropriato.
Per un dato caso d'uso, i responsabili dovrebbero definire un prodotto dati chiaro: l'insieme definito di informazioni, metriche, responsabilità, aspettative di qualità e regole di accesso da cui dipende un team o un sistema di automazione. Ad esempio, un prodotto dati relativo all'evasione degli ordini potrebbe combinare righe d'ordine, inventario disponibile, stato della spedizione, priorità del cliente e motivi delle eccezioni. Ogni campo necessita di una definizione concordata e di un responsabile.
Una solida base pratica affronta anche le questioni di integrazione e tempistica. Una dashboard basata sui dati del giorno precedente può essere adeguata per la pianificazione mensile della capacità, ma insufficiente per il recupero degli ordini in giornata. Allo stesso modo, un assistente basato sull'intelligenza artificiale che suggerisce le azioni successive necessita di accedere ai documenti di policy correnti, allo stato attuale delle transazioni e al contesto del cliente o dell'asset di riferimento. L'architettura dovrebbe riflettere la velocità e l'affidabilità richieste dal processo aziendale, non una generica preferenza tecnologica.
La governance è altrettanto operativa. Significa che qualcuno può rispondere a domande semplici ma importanti: Chi è il responsabile di questo campo? Cosa succede se la validazione fallisce? Qual è il sistema di riferimento? Chi può utilizzare i dati per un caso d'uso di intelligenza artificiale? Come vengono protette le informazioni sensibili? Questi controlli riducono l'onere di manutenzione che spesso si presenta dopo che un progetto pilota iniziale è stato dichiarato un successo.
Quando l'IA può iniziare prima che le fondamenta siano completate
L'approccio "prima le fondamenta" non dovrebbe diventare una scusa per rimandare indefinitamente un lavoro utile. Alcune iniziative di intelligenza artificiale possono iniziare presto, quando il processo è ben definito, il rischio è gestibile e i dati di input sono controllati.
Un assistente alla conoscenza per le politiche interne può rappresentare un caso d'uso iniziale sensato se attinge a documenti approvati, ha autorizzazioni chiare e indirizza i dipendenti al materiale di origine quando il livello di fiducia è basso. la classificazione dei documenti può funzionare bene quando le tipologie di documenti sono limitate e gli output incerti vengono esaminati da personale umano. Questi progetti aiutano i team a sviluppare pratiche di adozione, governance e misurazione, mentre proseguono i miglioramenti più ampi relativi ai dati.
Il compromesso riguarda la portata. I progetti di IA in fase iniziale non dovrebbero prendere decisioni di grande impatto senza dati affidabili, tracciabilità e percorsi di escalation. Un assistente può redigere una risposta a un fornitore, ma non dovrebbe modificare autonomamente i termini di pagamento sulla base di dati incompleti. Un modello previsionale può segnalare probabili problemi di magazzino, ma non dovrebbe sostituire il giudizio del pianificatore finché le sue prestazioni non siano state testate in condizioni di normale variabilità, periodi di picco e casi limite.
La corretta sequenza dipende da quattro condizioni:
- Il processo aziendale ha un responsabile definito e un risultato misurabile.
- I dati richiesti sono disponibili con una qualità sufficiente per la decisione prevista.
- Le eccezioni possono essere instradate a una persona o a un flusso di lavoro controllato.
- I requisiti in materia di sicurezza, accesso e responsabilità sono chiari.
Se queste condizioni vengono soddisfatte, un caso d'uso dell'IA può apportare valore, evidenziando al contempo i punti in cui la base di dati necessita di ulteriori miglioramenti.
Misurare il risultato aziendale, non l'attività modello
I programmi di implementazione dell'IA spesso riportano metriche di attività: utenti abilitati, richieste inviate, documenti elaborati o modelli distribuiti. Questi dati indicano l'adozione, ma non stabiliscono il valore operativo.
I dirigenti aziendali dovrebbero collegare ogni iniziativa a indicatori di processo. In ambito finanziario, ciò potrebbe significare tasso di elaborazione automatizzata, tempo di risoluzione delle eccezioni, costo per fattura o puntualità nei pagamenti. Nelle operazioni con i clienti, potrebbe significare risoluzione al primo contatto, tempo di gestione, arretrati di casi e rispetto dei livelli di servizio. Nel settore manifatturiero, gli indicatori rilevanti potrebbero includere stabilità della pianificazione, tempi di inattività non pianificati, scarti e tempo di risoluzione dei problemi di qualità.
Definire un punto di riferimento è fondamentale. Senza di esso, un team non può distinguere un reale incremento di produttività da variazioni stagionali dei volumi, cambiamenti di personale o soluzioni temporanee. È inoltre necessario monitorare gli indicatori di qualità oltre alla velocità. Un processo di classificazione più rapido che invia un maggior numero di casi errati alle fasi successive non si traduce in un aumento di produttività.
È qui che l'integrazione dei processi diventa fondamentale. Riprogettazione dei processi, gestione dei dati, automazione, intelligenza artificiale, dashboard e gestione del cambiamento dovrebbero rafforzarsi a vicenda. Quando diversi fornitori gestiscono ogni livello senza un modello operativo condiviso, le aziende spesso si ritrovano con responsabilità frammentate e costosi passaggi di consegne. Un'unica roadmap di trasformazione rende visibili le dipendenze e aiuta i team a dare priorità al lavoro che produce risultati misurabili.
Una sequenza pratica per i leader aziendali
Iniziate con uno o due processi in cui il volume delle transazioni, l'impegno manuale, i ritardi decisionali o il rischio di non conformità sono elevati. Mappate il flusso di lavoro attuale attraverso le diverse funzioni e i sistemi. Quantificate le rilavorazioni, i tempi di attesa, il volume delle eccezioni e il costo della scarsa visibilità.
Successivamente, definisci il processo operativo di destinazione e i dati necessari per gestirlo. Standardizza le definizioni, stabilisci le responsabilità e collega i sistemi che contengono i record pertinenti. Automatizza le fasi prevedibili in cui le regole sono stabili. Questo spesso crea valore immediato prima dell'introduzione di un'intelligenza artificiale avanzata.
Applica quindi l'IA laddove migliori una specifica decisione, interazione o attività relativa a dati non strutturati. Progetta per la revisione umana laddove il rischio o l'incertezza siano elevati e monitora i risultati dopo l'implementazione. Espandi solo dopo che la prima implementazione abbia dimostrato che qualità, governance ed economicità si mantengono in condizioni operative reali.
Ective affronta questa sequenza come una disciplina operativa: organizzare il flusso di lavoro, strutturare i dati, automatizzare le attività ripetitive e applicare l'intelligenza artificiale laddove migliori significativamente le prestazioni. Il risultato non è un progetto pilota isolato, bensì una capacità operativa estendibile a diverse funzioni e unità aziendali.
I programmi di intelligenza artificiale più efficaci non iniziano con la selezione di un modello. Partono da un processo aziendale che merita di essere migliorato, da dati che supportino una decisione affidabile e da uno standard chiaro per definire cosa si intende per prestazioni migliori. Partendo da queste basi, ogni successivo investimento in IA avrà molte più probabilità di diventare parte integrante delle operazioni quotidiane, anziché rimanere una semplice dimostrazione promettente.