Un responsabile di stabilimento desidera una visione affidabile delle scorte, dei ritardi di produzione, delle prestazioni dei fornitori e dei rischi di manutenzione. Il reparto finanziario ha bisogno degli stessi dati per la riconciliazione con l'ERP. Il servizio clienti necessita di informazioni aggiornate sullo stato degli ordini senza dover aprire un ticket al reparto IT. È qui che la scelta tra data fabric e data mesh diventa cruciale: determina la velocità con cui dati affidabili possono supportare il lavoro in tutta l'azienda e chi è responsabile quando ciò non avviene.
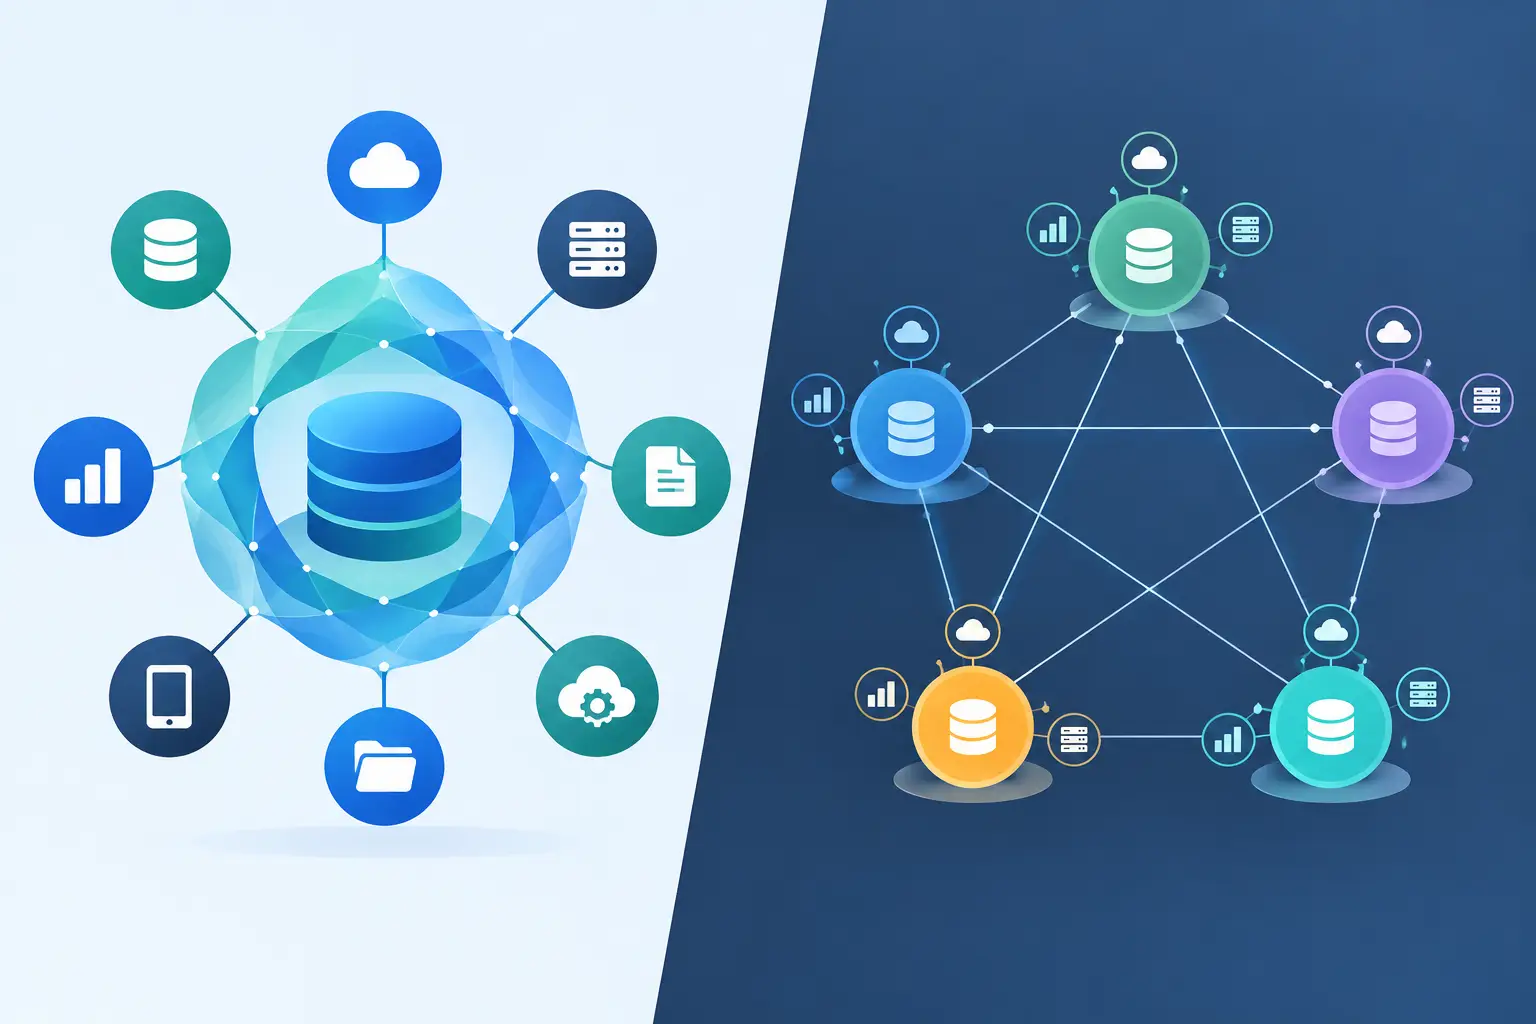
Nessuno dei due approcci è un prodotto software o una scorciatoia per aggirare una gestione dei dati inefficiente. Entrambi possono migliorare l'accesso ai dati attraverso sistemi frammentati. La differenza risiede nel modello operativo. Una data fabric enfatizza la gestione automatizzata e connessa dei dati in tutta l'organizzazione. Una data mesh distribuisce la responsabilità dei prodotti dati ai domini aziendali che creano e interpretano i dati.
Per le aziende con un'elevata intensità operativa, la scelta giusta dipende meno dalla terminologia di mercato e più dalla maturità dei processi, dalla capacità di governance, dalla complessità del sistema e dai risultati aziendali che il programma di gestione dei dati deve supportare.
Data Fabric contro Data Mesh: la differenza fondamentale
Una data fabric è un approccio architetturale per integrare, gestire e distribuire dati provenienti da diverse fonti. Si avvale di metadati, cataloghi di dati, pipeline di integrazione, modelli semantici e automazione per rendere i dati distribuiti più facili da trovare, comprendere e utilizzare. L'obiettivo è un livello dati connesso che riduca lo sforzo necessario per passare da un sistema ERP a un CRM, da un sistema di produzione all'altro, da documenti a piattaforme cloud e applicazioni legacy.
In pratica, un'infrastruttura di dati offre spesso ai team aziendali un modo più coerente per identificare i dati, applicare controlli di qualità, gestire gli accessi e fornire informazioni a dashboard, flussi di lavoro automatizzati, analisi e casi d'uso di intelligenza artificiale. È particolarmente utile quando la stessa domanda operativa richiede informazioni provenienti da molti sistemi.
Una data mesh è un modello operativo decentralizzato per la gestione dei dati. Anziché trattare i dati come qualcosa che un team centrale raccoglie e prepara per tutti gli altri, assegna ai diversi domini la responsabilità di pubblicare prodotti dati utilizzabili. L'ufficio acquisti si occupa dei prodotti dati relativi ai fornitori, la produzione dei prodotti dati relativi alla produzione stessa e la finanza dei prodotti dati relativi alle performance finanziarie. Ogni dominio è tenuto a fornire dati reperibili, comprensibili, gestiti e idonei all'utilizzo da parte di altri.
Il modello mesh si basa su quattro concetti pratici: proprietà del dominio, dati come prodotto, infrastruttura dati self-service e governance federata. Il suo obiettivo è eliminare il team centrale dedicato ai dati come collo di bottiglia nella distribuzione, senza compromettere gli standard aziendali.
La distinzione è importante. Un'architettura a tessuto risponde principalmente alla domanda: "Come connettiamo e gestiamo il nostro patrimonio di dati distribuito?". Un'architettura a maglia risponde principalmente alla domanda: "Come distribuiamo la responsabilità per la qualità e l'usabilità dei dati su scala aziendale?". Un'organizzazione matura può utilizzare entrambe.
Quando una Data Fabric rappresenta il punto di partenza migliore
L'adozione di una data fabric rappresenta spesso la prima scelta più efficace per le aziende che si trovano a gestire sistemi frammentati, definizioni incoerenti e una proprietà dei dati limitata. Queste condizioni sono comuni dopo anni di acquisizioni, variazioni regionali dei processi, personalizzazioni di sistemi ERP e acquisti tecnologici guidati dai singoli reparti.
Consideriamo un'organizzazione di servizi condivisi che elabora elevati volumi di fatture, ordini di acquisto, reclami o richieste di assistenza. Le informazioni necessarie per automatizzare e monitorare questi processi possono essere sparse in diversi sistemi ERP, archivi documentali, e-mail, strumenti di gestione dei flussi di lavoro, portali dei fornitori e fogli di calcolo. Prima di assegnare la responsabilità dei dati a più domini, l'organizzazione necessita di un metodo affidabile per connettere queste fonti, stabilire identificatori comuni, documentare le definizioni e applicare i controlli di accesso.
Una struttura di supporto supporta tale base. Può ridurre la preparazione manuale dei dati, migliorare la tracciabilità e rendere disponibili informazioni affidabili per casi d'uso comuni come la rendicontazione del capitale circolante, la gestione delle eccezioni, il process mining o la gestione dei documenti assistita dall'intelligenza artificiale. Aiuta inoltre i team centrali a identificare i casi in cui i record sono in conflitto e i campi critici risultano incompleti.
Ciò non significa centralizzare ogni set di dati in un'unica piattaforma fisica. Un'infrastruttura ben progettata può connettere i dati ovunque risiedano, applicando al contempo metadati e governance coerenti. Questo è utile per le aziende che devono conservare i dati in sistemi specifici per motivi normativi, operativi o di costo.
Il compromesso è di natura organizzativa. Un'infrastruttura gestita centralmente può trasformarsi in un'ulteriore coda di servizi di proprietà dell'IT se i team aziendali non vengono coinvolti nella definizione delle regole e delle priorità relative alla qualità dei dati. La tecnologia può connettere i sistemi con successo, ma i team operativi continuano a non essere d'accordo sul significato di "consegna puntuale", "cliente attivo" o "inventario disponibile". L'architettura non può risolvere una decisione aziendale mancante.
Quando una mesh di dati può creare più valore
Una rete di dati è più efficace quando un'azienda ha domini di business distinti con leader competenti, responsabilità chiare e una scala sufficiente a giustificare una distribuzione decentralizzata. Funziona al meglio quando i dati non sono semplicemente un output IT, ma una risorsa aziendale gestita e legata alle prestazioni operative.
Ad esempio, un produttore globale può avere domini separati ma interdipendenti per ingegneria, catena di fornitura, produzione, qualità, vendite e assistenza post-vendita. Ogni dominio genera dati con un contesto specifico. Il team di qualità comprende le classificazioni dei difetti. La catena di fornitura comprende le eccezioni relative ai tempi di consegna dei fornitori. I team di assistenza comprendono la base installata e lo stato della garanzia. Chiedere a un unico team centrale di modellare ogni dettaglio, rispondere a ogni domanda e pubblicare ogni set di dati può rallentare il processo decisionale.
In un modello a rete, questi domini pubblicano prodotti dati con definizioni, aspettative di servizio, proprietà e misure di qualità documentate. Un prodotto dati della catena di fornitura potrebbe fornire metriche di performance dei fornitori approvati, storico dei tempi di consegna e rischio di consegna attuale. I reparti Finanza e Operazioni possono utilizzarlo con fiducia perché il proprietario, la frequenza di aggiornamento, l'uso consentito e le soglie di qualità sono espliciti.
Il vantaggio è la velocità unita alla responsabilità. Gli esperti del settore mantengono i dati più vicini al processo, mentre i consumatori possono trovarli e utilizzarli senza dover ricreare gli stessi estratti in ogni reparto.
Il compromesso è sostanziale. Una rete mesh richiede più che l'assegnazione di responsabili in una presentazione di governance. I team di dominio necessitano di competenze, capacità, disciplina nella gestione del prodotto e standard tecnici condivisi. Senza strumenti self-service e una governance applicabile, la decentralizzazione può produrre versioni multiple della stessa metrica, pratiche di sicurezza incoerenti e un costoso insieme di pipeline locali.
Una rete di dati non dovrebbe essere utilizzata per formalizzare i silos esistenti. Se ogni dominio pubblica i dati nel proprio formato e con il proprio vocabolario, l'azienda si ritrova con una frammentazione distribuita anziché con un valore distribuito.
Architettura e proprietà devono lavorare in sinergia
La decisione più utile raramente si basa sulla scelta tra data fabric e data mesh come opzioni mutuamente esclusive. Le funzionalità di un data fabric possono fornire l'infrastruttura e il livello di governance che rendono un data mesh praticabile. Un modello operativo di un data mesh può garantire la responsabilità aziendale necessaria affinché un data fabric non si trasformi in una piattaforma tecnicamente elegante ma scarsamente adottata.
Questo approccio combinato è particolarmente rilevante quando l'azienda desidera scalare l'automazione e l'IA. Un programma di automazione intelligente necessita di più del semplice accesso ai dati di origine. Richiede definizioni chiare, registri affidabili, accesso autorizzato, trasformazioni tracciabili e responsabili di processo in grado di intervenire in caso di eccezioni. Le applicazioni GenAI aggiungono un ulteriore requisito: devono recuperare le informazioni da fonti autorizzate, aggiornate e ben classificate, anziché da raccolte di documenti non controllate.
Un modello pratico potrebbe centralizzare funzionalità comuni come la gestione delle identità e degli accessi, la gestione dei metadati, le regole sui dati master, gli standard di integrazione, l'osservabilità e il livello semantico. I domini aziendali sarebbero quindi responsabili della qualità e del ciclo di vita dei prodotti dati più strettamente legati ai loro processi. Gli standard centralizzati rimarrebbero invariati, mentre la responsabilità ricadrebbe su chi possiede le conoscenze operative.
Questa struttura supporta anche una consegna misurabile. Invece di valutare il programma in base al numero di set di dati acquisiti o dashboard pubblicati, è opportuno definire risultati come un minor numero di riconciliazioni manuali, una reportistica di fine mese più rapida, tassi di eccezione delle fatture inferiori, tempi del ciclo ordine-incasso ridotti o una risposta più rapida alle interruzioni della produzione.
Come prendere la decisione senza avviare un altro programma di piattaforma
Partite dai processi aziendali, non dai diagrammi di architettura. Individuate i processi interfunzionali in cui dati inadeguati causano ritardi, rilavorazioni, rischi o mancati ricavi. Per un'azienda manifatturiera, potrebbe trattarsi del ciclo previsione-pianificazione, del ciclo approvvigionamento-pagamento o della gestione degli incidenti di qualità. Per un fornitore di servizi sanitari, potrebbe trattarsi della gestione delle segnalazioni, delle operazioni di rimborso o della pianificazione della capacità.
Successivamente, valutate le fondamenta attuali. I team sono in grado di identificare la fonte autorevole per le entità chiave? Le definizioni aziendali sono condivise? È disponibile la tracciabilità per i report critici? Gli utenti autorizzati possono accedere alle informazioni senza doverle estrarre manualmente più volte? Se la risposta è prevalentemente negativa, le funzionalità dell'infrastruttura e la governance dei dati di base sono probabilmente la priorità.
Successivamente, valutate la predisposizione organizzativa per la gestione distribuita dei dati. I domini dispongono di responsabili designati in grado di prendere decisioni sulla qualità dei dati? Possono dedicare personale alla manutenzione dei prodotti dati? Gli indicatori di performance sono allineati in modo che i team traggano vantaggio dalla condivisione delle informazioni anziché dalla loro protezione? In caso contrario, un'implementazione completa di una rete mesh creerà impegni che l'organizzazione non sarà in grado di sostenere.
Un approccio graduale è solitamente più efficace di una riprogettazione completa. Scegliete un processo di alto valore con sponsor ben definiti e problematiche misurabili. Stabilite le sue definizioni, le regole di qualità dei dati, il modello di accesso e i requisiti di erogazione. Create le necessarie funzionalità di integrazione e di gestione dei metadati. Infine, assegnate la responsabilità in base a dove risiedono effettivamente le conoscenze aziendali e i diritti decisionali.
Ective affronta questo lavoro come una disciplina esecutiva: la riprogettazione dei processi, l'architettura dei dati, la governance, l'automazione e la misurazione devono rafforzarsi a vicenda. Un modello dati scollegato dal processo operativo non produrrà miglioramenti duraturi, indipendentemente dalla piattaforma su cui si basa.
Progettare per prendere decisioni, non per generare volumi di dati
La strategia dati più efficace è quella che aiuta un manager a prendere decisioni migliori prima che la finestra operativa si chiuda. Per alcune aziende, questo inizia con una struttura dati che mette ordine in un parco tecnologico complesso. Per altre, significa affidare la responsabilità dei prodotti dati a domini competenti attraverso un modello a rete. Per molte, significa costruire le fondamenta condivise di una struttura dati, stabilendo progressivamente la responsabilità in stile rete laddove ciò generi un chiaro valore aziendale.
Scegli il modello che la tua organizzazione è in grado di governare, gestire e misurare. Quindi, dimostrane l'efficacia nei processi in cui dati affidabili possono eliminare gli attriti dal lavoro quotidiano.