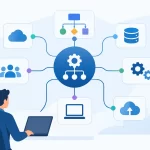
Eine Referenzarchitektur für Datenmanagement ist kein Technologiediagramm für ein Architekturprüfungsgremium. Sie ist der operative Fahrplan, der bestimmt, ob Unternehmensdaten schnellere Arbeitsabläufe, skalierbare Automatisierung, zuverlässiges Reporting und glaubwürdige KI-Anwendungsfälle unterstützen können. Fehlt dieser Fahrplan, kompensieren Teams dies mit Tabellenkalkulationen, Punkt-zu-Punkt-Integrationen, manuellen Abgleichen und Dashboards, die widersprüchliche Datenversionen erzeugen.
Für betriebsintensive Organisationen sind die Kosten messbar. Die Auftragsabwicklung verlangsamt sich, wenn Kunden- oder Produktdaten in verschiedenen Systemen in Konflikt stehen. Finanzteams verbringen Berichtszyklen mit der Validierung von Datenextrakten, anstatt die Performance zu analysieren. Automatisierungsprogramme geraten ins Stocken, weil Bots und Workflows den Eingaben nicht vertrauen können. Eine Referenzarchitektur schafft die notwendige Struktur, um Daten in eine unternehmensweite Fähigkeit statt in eine wiederkehrende operative Einschränkung zu verwandeln.
Was eine Referenzarchitektur für Datenmanagement leisten sollte
Eine Referenzarchitektur definiert die Kernfunktionen, Rollen, Muster und Kontrollen, die für die Erfassung, Organisation, Verwaltung, Verteilung und Nutzung von Geschäftsdaten erforderlich sind. Sie ist bewusst wiederverwendbar. Anstatt jede Integration, jedes Datenprodukt oder jede Reporting-Lösung von Grund auf neu zu entwickeln, legt das Unternehmen gemeinsame Entscheidungen fest, die die Entwicklungsteams wiederholt anwenden können.
Ziel ist es nicht, alle Datensätze auf einer einzigen Plattform zu zentralisieren. Einige Daten müssen aus Gründen der Performance, der Compliance oder der Prozessverantwortung in den operativen Systemen verbleiben. Ziel ist es vielmehr, Daten verständlich, kontrollierbar und zum richtigen Zeitpunkt im Prozess verfügbar zu machen.
Ein Hersteller kann beispielsweise Produktionsdaten in Systemen auf Werksebene speichern und gleichzeitig freigegebene Produkt-, Lieferanten-, Bestands- und Finanzdaten für die Unternehmensplanung und das Leistungsmanagement konsolidieren. Die Architektur sollte definieren, wie diese Bereiche identifiziert, validiert, geteilt, gesichert und überwacht werden. Außerdem sollte klar sein, welches System für welches kritische Attribut maßgeblich ist.
Eine sinnvolle Architektur beantwortet praktische Fragen, bevor Entwicklungsteams teure Workarounds entwickeln müssen: Wem gehört der Kundenstamm? Wie werden Produktdefinitionen freigegeben? Welche Qualitätsregeln blockieren eine Transaktion und welche führen zu einer Ausnahme zur Überprüfung? Wie verarbeitet ein Workflow Daten aus verschiedenen Systemen? Auf welche Informationen kann ein KI-Assistent zugreifen und unter welchen Kontrollen?
Beginnen Sie mit Prozess- und Datendomänen, nicht mit Plattformen
Viele Architekturprogramme beginnen mit der Auswahl einer Datenplattform, eines Datenspeichers, eines Datenkatalogs oder eines Integrationstools. Diese Technologien sind wichtig, aber nicht der Ausgangspunkt. Eine Plattform kann weder eine unklare Geschäftsdefinition noch einen fragmentierten Genehmigungsprozess oder eine nie zugewiesene Zuständigkeit lösen.
Beginnen Sie mit den Geschäftsprozessen, die das höchste Volumen, die höchsten Kosten, das größte Risiko oder das größte Wachstumspotenzial aufweisen. Typische Beispiele sind Beschaffung, Auftragsabwicklung, Produktionsplanung, Schadensbearbeitung und Mitarbeiter-Onboarding. Ermitteln Sie, wo jeder Prozess Daten erzeugt, ändert, validiert und nutzt. Dadurch werden die Schnittstellen sichtbar, an denen mangelhafte Daten zu Nacharbeit führen und an denen die Automatisierung scheitert.
Als Nächstes werden die Daten in Geschäftsbereiche unterteilt. Typische Bereiche sind Kunden-, Lieferanten-, Produkt-, Anlagen-, Mitarbeiter-, Finanz-, Auftrags- und Vertragsdaten. Jeder Bereich benötigt einen verantwortlichen Geschäftsbereichsleiter, definierte Datenprodukte oder gemeinsam genutzte Datensätze, Qualitätsanforderungen sowie Zugriffs- und Aufbewahrungsregeln.
Dieser Ansatz verhindert einen häufigen Fehler: den Aufbau eines technisch leistungsfähigen Datenbestands ohne geschäftliche Relevanz. Unternehmensteams benötigen selten mehr Rohdaten. Sie benötigen verlässliche, nutzbare Informationen, die mit Entscheidungen und Arbeitsabläufen verknüpft sind.
Die Kernschichten der Architektur
Eine skalierbare Architektur benötigt weder einen einzelnen Anbieter noch ein einheitliches Speichermuster. Sie erfordert jedoch klar definierte Schichten und Verantwortlichkeiten zwischen diesen Schichten.
Quell- und Betriebsschicht
Diese Ebene umfasst ERP-, CRM-, Fertigungs-, Lager-, Personal-, Finanz- und spezialisierte operative Systeme. Diese Systeme unterstützen Transaktionen und sollten die maßgeblichen Datenquellen für die von ihnen verwalteten Daten bleiben. Die Architektur muss die maßgeblichen Datenquellen dokumentieren und definieren, wie Änderungen erfasst werden, ohne kritische Prozesse unnötig zu belasten.
Integrations- und Datenbewegungsschicht
Daten werden über APIs, Ereignisse, Batch-Pipelines, Dateiaustausch und Workflow-Integrationen übertragen. Das optimale Vorgehen hängt vom Anwendungsfall ab. Die Freigabe einer Kreditsperre erfordert möglicherweise Informationen in nahezu Echtzeit, während dies für monatliche Gewinnberichte unter Umständen nicht notwendig ist. Die Architektur sollte Integrationsmethoden, Fehlerbehandlung, Abgleich und Beobachtbarkeit standardisieren, damit nicht jede neue Verbindung einen zusätzlichen Wartungsaufwand verursacht.
Speicher-, Transformations- und Bereitstellungsschicht
Diese Ebene bereitet Daten für operatives Reporting, Analysen, Planung, Automatisierung und KI auf. Je nach Anforderungen kann sie einen operativen Datenspeicher, ein Data Warehouse, eine Datenplattform, domänenspezifische Datenprodukte oder eine Kombination davon umfassen. Entscheidend für die Gestaltung ist nicht die Bezeichnung, sondern ob das Unternehmen die für den jeweiligen Anwendungsfall erforderlichen Daten mit der benötigten Geschwindigkeit, Detailtiefe und Zuverlässigkeit bereitstellen kann.
Die Transformationslogik muss transparent und kontrollierbar sein. Werden Umsatz, Lagerbestand oder Kundenstatus in verschiedenen Berichten unterschiedlich berechnet, hat die Architektur das Kernproblem nicht gelöst. Wiederverwendbare Geschäftslogik und dokumentierte Kennzahlen reduzieren widersprüchliche Berichte und beschleunigen die Bereitstellung.
Governance-, Sicherheits- und Metadatenebene
Governance darf nicht als separates Richtliniendokument außerhalb der Architektur stehen. Sie muss in die Art und Weise eingebettet sein, wie Daten erstellt, klassifiziert, abgerufen, geändert und überwacht werden. Diese Ebene umfasst Geschäftsglossare, Metadaten, Datenherkunft, rollenbasierte Zugriffskontrollen, Aufbewahrungsfristen, Datenqualitätskontrollen, Prüfprotokolle und Problemmanagement.
Metadaten sind besonders wertvoll, weil sie Teams Kontext liefern. Ein Dashboard-Nutzer muss wissen, was eine Kennzahl bedeutet, woher sie stammt und wann sie zuletzt aktualisiert wurde. Ein Automatisierungsentwickler muss wissen, ob ein Feld stabil und zur Verwendung freigegeben ist. Ein Data Scientist muss verstehen, ob historische Werte neu berechnet oder gelöscht wurden. Ohne diesen Kontext führt der Zugriff auf mehr Daten oft zu mehr Unsicherheit.
Konsum- und Entscheidungsebene
Die Architektur sollte die Bereiche unterstützen, in denen die eigentliche Arbeit stattfindet: Geschäftsanwendungen, Dashboards, Planungstools, Workflow-Engines, Automatisierungsplattformen und KI-Dienste. Hier beweist die Architektur ihren kommerziellen Wert.
Ein leistungsstarkes Modell verlangt von den Nutzern nicht, ihren Arbeitsablauf zu unterbrechen, um in einer separaten Berichtsumgebung nach Informationen zu suchen. Es stellt die relevanten Daten direkt im Prozess bereit, sei es die Anzeige eines Kundenrisiko-Scores bei der Auftragsfreigabe, die Weiterleitung einer Lieferantenausnahme an den zuständigen Verantwortlichen oder die Bereitstellung einer vollständigen Fallhistorie für das Serviceteam.
Design für Datenqualität als operative Kontrolle
Programme zur Datenqualitätssicherung scheitern oft, weil sie Fehler messen, ohne die Prozesse zu verändern, die diese Fehler verursachen. Eine monatliche Scorecard mit unvollständigen Lieferantendatensätzen ist nur dann sinnvoll, wenn sie zu klarer Verantwortlichkeit, Korrektur und Prävention führt.
Behandeln Sie Qualitätsregeln wie operative Kontrollen. Definieren Sie die kritischen Datenelemente für jeden Prozess, z. B. Zahlungsbedingungen, Steuerklassifizierung, Materiallieferzeit, Bonität des Kunden oder Bankverbindung. Legen Sie Schwellenwerte basierend auf den Auswirkungen auf das Geschäft fest. Ein fehlendes optionales Marketingfeld sollte nicht die gleiche Dringlichkeit erhalten wie eine ungültige Zahlungsanweisung.
Das Qualitätsmanagement sollte vier miteinander verbundene Praktiken umfassen:
- Prävention durch Pflichtfelder, Validierungsregeln, Genehmigungsworkflows und kontrollierte Referenzdaten.
- Erkennung durch Profiling, Monitoring, Abgleich und Ausnahmeberichterstattung.
- Problemlösung durch zugewiesene Verantwortliche, Service-Levels und nachvollziehbare Abläufe zur Behebung von Mängeln.
- Verbesserung durch Ursachenanalyse, die den vorgelagerten Prozess, die Richtlinie oder die Systemkonfiguration verändert.
Der Zielkonflikt ist offensichtlich. Übermäßige Kontrollen können legitime Arbeitsabläufe verlangsamen, während zu schwache Kontrollen Risiken und Nacharbeiten nachgelagerte Prozesse verursachen. Ein optimales Design sieht eine strengere Validierung risikoreicher Daten vor und nutzt praktikable Ausnahmebehandlungspfade, wenn Flexibilität im Geschäftsbetrieb erforderlich ist.
Governance verantwortungsvoll und schlank gestalten
Governance verliert an Effektivität, wenn sie als Gremium ohne Entscheidungsbefugnis im Tagesgeschäft behandelt wird. Sie verliert auch an Popularität, wenn jede Datenanfrage einen langwierigen Genehmigungsprozess erfordert. Die Lösung liegt nicht in weniger Governance, sondern in einer Governance, die auf klarer Verantwortlichkeit und nachvollziehbaren Entscheidungen basiert.
Geschäftsinhaber sollten Bedeutung, Qualitätsanforderungen und zulässige Nutzung ihrer Bereiche definieren. Datenverantwortliche sollten Definitionen verwalten, Probleme überwachen und deren Behebung koordinieren. IT-Teams sollten Kontrollen, Integrationsmuster, Sicherheitsmaßnahmen und den Plattformbetrieb implementieren. Prozessverantwortliche sollten sicherstellen, dass die Regeln den realen Arbeitsabläufen entsprechen.
Ein zentrales Datenbüro kann Standards festlegen und domänenübergreifende Konflikte lösen, sollte aber nicht Eigentümer aller Datensätze werden. Diejenigen, die am nächsten am Prozess beteiligt sind, können in der Regel am besten beurteilen, ob Daten für den jeweiligen Zweck geeignet sind. Zentrale Teams stellen das gemeinsame Modell, die Werkzeuge, die Qualitätssicherung und den Eskalationsweg bereit, die es ermöglichen, dass lokale Zuständigkeiten im Unternehmensmaßstab funktionieren.
Für Automatisierung und KI entwickeln, ohne neue Risiken zu schaffen
Automatisierung und KI steigern zwar den Wert sauberer, vernetzter Daten, decken aber auch schnell Schwachstellen auf. Ein Workflow kann Tausende von Transaktionen mit derselben fehlerhaften Regel verarbeiten. Eine KI-Lösung kann überzeugende Ergebnisse auf Basis veralteter, unvollständiger oder unautorisierter Informationen generieren.
Die Architektur sollte genehmigte Datenschnittstellen für Automatisierungs- und KI-Anwendungsfälle definieren. Diese Schnittstellen sollten dokumentierte Schemata, Zugriffskontrollen, Qualitätsprüfungen, Datenherkunft und Überwachung umfassen. Bei Entscheidungen mit hoher Tragweite sollte eine menschliche Überprüfung beibehalten, die verwendeten Quelldaten protokolliert und Schwellenwerte für die Eskalation eines Falls festgelegt werden.
Dies bedeutet nicht, dass jeder Anwendungsfall das gleiche Kontrollniveau erfordert. Ein generativer KI-Assistent, der interne Supportartikel zusammenfasst, weist ein anderes Risikoprofil auf als ein KI-Modell, das Zahlungsaktionen oder Produktionsänderungen empfiehlt. Architekturentscheidungen sollten die finanziellen, betrieblichen, regulatorischen und kundenbezogenen Auswirkungen jedes Anwendungsfalls berücksichtigen.
Die Architektur in einen Lieferplan umwandeln
Eine Referenzarchitektur beweist ihren Wert, wenn sie die Ergebnisse der Leistungserbringung verändert. Beginnen Sie mit einer fokussierten Gruppe wertvoller Prozesse und definieren Sie darauf aufbauend eine minimale, funktionsfähige Architektur. Legen Sie gemeinsame Domänendefinitionen, Verantwortlichkeiten, Integrationsstandards, Qualitätskontrollen und Nutzungsmuster fest. Erweitern Sie die Architektur anschließend mithilfe der Erfahrungen aus der Implementierung.
Den Fortschritt messen: weniger manuelle Abstimmungen, schnellere Fallbearbeitung, geringeres Ausnahmeaufkommen, kürzere Berichtszyklen, verbesserte durchgängige Verarbeitung und reduzierter Aufwand für die Einführung neuer Automatisierungen. Technische Kennzahlen wie die Zuverlässigkeit der Datenpipeline und die Aktualität der Daten sind wichtig, sollten aber die operativen Ergebnisse unterstützen.
Ective betrachtet diese Aufgabe als Teil eines integrierten Transformationsprogramms. Prozessneugestaltung, Datenarchitektur, Automatisierung, Dashboards und KI-Implementierung müssen sich gegenseitig verstärken. Der separate Aufbau dieser Fähigkeiten führt in der Regel zu einer Verlagerung der Komplexität von einem Team zum nächsten.
Der sinnvollste nächste Schritt ist die Auswahl eines Prozesses, bei dem fehlerhafte Daten sichtbare operative Kosten verursachen, und die Rückverfolgung des Problems von der Datenquelle bis zur Entscheidungsfindung oder Automatisierung. Diese Vorgehensweise zeigt, welche Architekturentscheidungen jetzt getroffen werden müssen und welche warten können, bis der Business Case nachgewiesen ist.