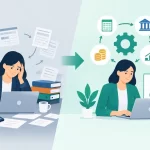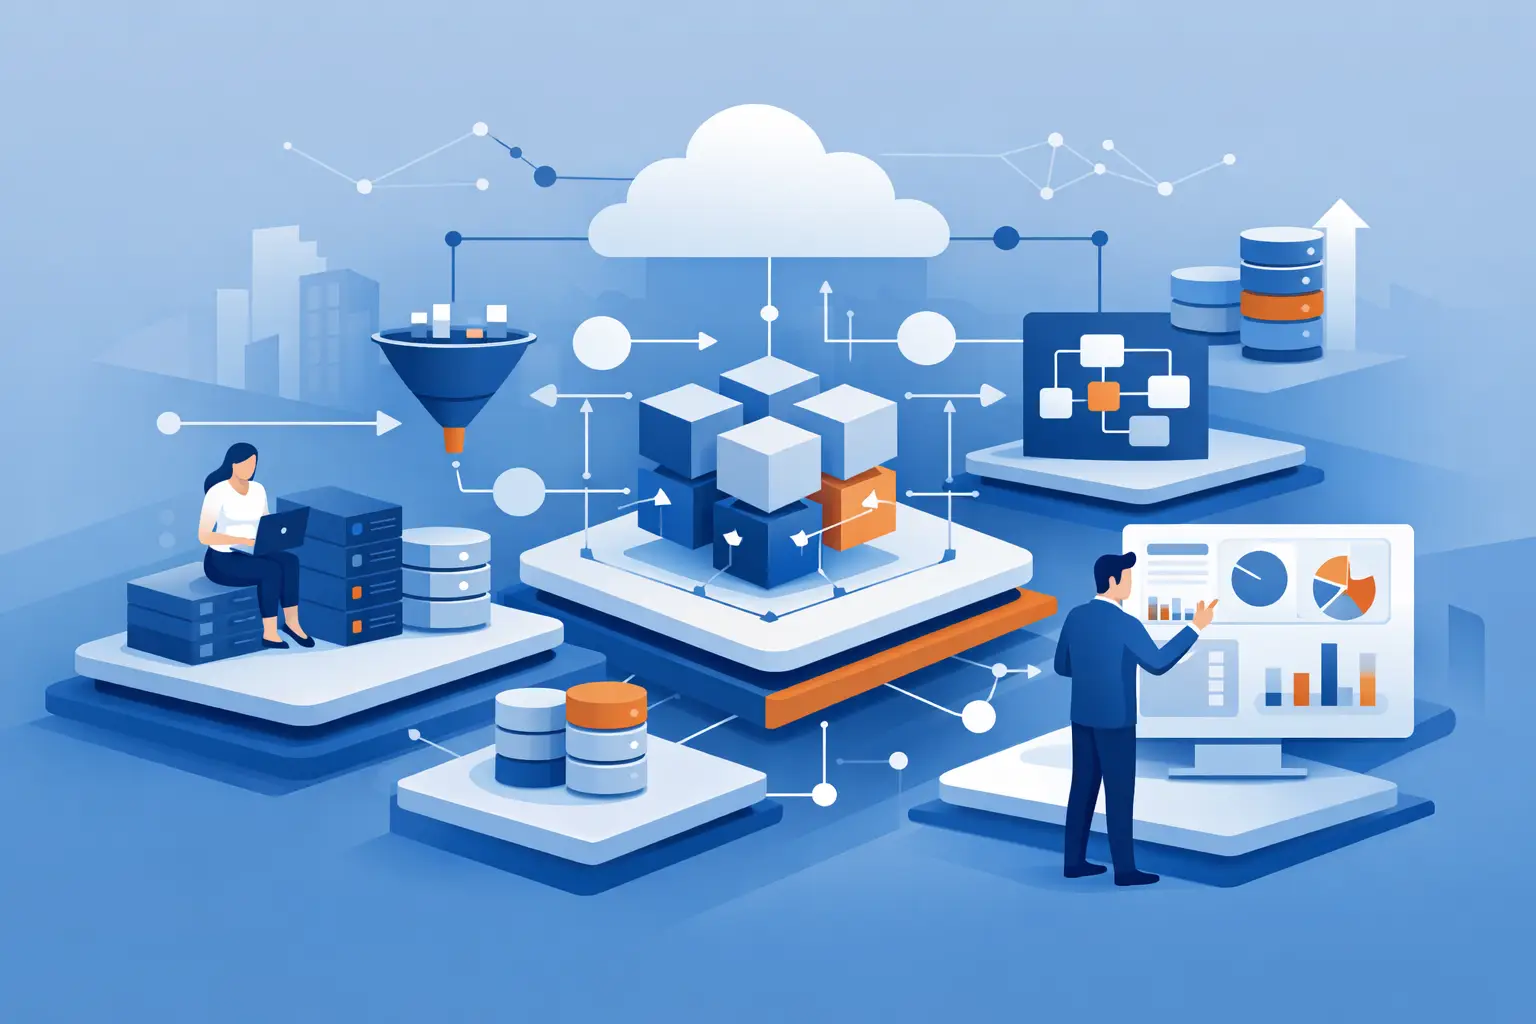
Un'architettura di riferimento per la gestione dei dati non è un diagramma tecnologico creato per un comitato di revisione dell'architettura. È il progetto operativo che determina se i dati aziendali possono supportare flussi di lavoro più rapidi, automazione scalabile, reportistica affidabile e casi d'uso credibili dell'IA. Quando questo progetto manca, i team compensano con fogli di calcolo, integrazioni punto a punto, riconciliazioni manuali e dashboard che producono versioni contrastanti della verità.
Per le organizzazioni con un'elevata intensità operativa, il costo è tangibile. L'elaborazione degli ordini rallenta quando i dati relativi a clienti o prodotti sono in conflitto tra i diversi sistemi. I team finanziari impiegano i cicli di reporting a convalidare le estrazioni anziché ad analizzare le prestazioni. I programmi di automazione si bloccano perché i bot e i flussi di lavoro non possono fidarsi degli input che ricevono. Un'architettura di riferimento crea la struttura necessaria per trasformare i dati in una capacità aziendale anziché in un vincolo operativo ricorrente.
Cosa dovrebbe fare un'architettura di riferimento per la gestione dei dati
Un'architettura di riferimento definisce le funzionalità, i ruoli, i modelli e i controlli fondamentali necessari per raccogliere, organizzare, gestire, distribuire e utilizzare i dati aziendali. È progettata per essere riutilizzabile. Anziché progettare da zero ogni integrazione, prodotto dati o soluzione di reporting, l'organizzazione stabilisce decisioni comuni che i team di sviluppo possono applicare ripetutamente.
L'obiettivo non è centralizzare tutti i set di dati in un'unica piattaforma. Alcuni dati devono rimanere nei sistemi operativi per motivi di prestazioni, conformità o titolarità dei processi. L'obiettivo è rendere i dati comprensibili, controllabili e disponibili nel punto giusto di un processo.
Ad esempio, un produttore può conservare i dati relativi all'esecuzione della produzione nei sistemi a livello di stabilimento, consolidando al contempo i dati approvati relativi a prodotti, fornitori, inventario e aspetti finanziari per la pianificazione aziendale e la gestione delle prestazioni. L'architettura dovrebbe definire come questi domini vengono identificati, convalidati, condivisi, protetti e monitorati. Dovrebbe inoltre chiarire quale sistema è autorevole per ciascun attributo critico.
Un'architettura efficace risponde a domande pratiche prima che i team di sviluppo creino costose soluzioni alternative: a chi appartiene l'anagrafica clienti? Come vengono approvate le definizioni dei prodotti? Quali regole di qualità bloccano una transazione e quali creano un'eccezione per la revisione? Come un flusso di lavoro utilizza i dati provenienti da più sistemi? A quali informazioni può accedere un assistente AI e con quali controlli?
Parti dai domini di processo e dati, non dalle piattaforme
Molti progetti di architettura iniziano con la selezione di una piattaforma dati, un lakehouse, un catalogo o uno strumento di integrazione. Queste tecnologie sono importanti, ma non rappresentano il punto di partenza. Una piattaforma non può risolvere una definizione aziendale poco chiara, un processo di approvazione frammentato o la responsabilità di un progetto che non è mai stata assegnata.
Iniziate dai processi aziendali che presentano il volume, il costo, il rischio o il potenziale di crescita più elevati. Esempi comuni sono il ciclo acquisto-pagamento, il ciclo ordine-incasso, la pianificazione della produzione, l'elaborazione dei reclami e l'inserimento dei nuovi dipendenti. Mappate i punti in cui ciascun processo crea, modifica, convalida e utilizza i dati. Questo permette di individuare i passaggi in cui una scarsa qualità si traduce in rilavorazioni e dove l'automazione fallirà.
In seguito, è necessario organizzare i dati in domini aziendali. I domini tipici includono dati relativi a clienti, fornitori, prodotti, risorse, dipendenti, finanza, ordini e contratti. Ogni dominio necessita di un responsabile aziendale definito, prodotti dati o set di dati condivisi, aspettative di qualità e regole per l'accesso e la conservazione.
Questo approccio previene un errore comune: la creazione di un repository tecnicamente valido ma privo di rilevanza aziendale. I team aziendali raramente necessitano di una maggiore quantità di dati grezzi. Hanno bisogno di informazioni affidabili e utilizzabili, connesse a decisioni e flussi di lavoro.
Gli strati centrali dell'architettura
Un'architettura scalabile non richiede un unico fornitore o un unico modello di storage. Richiede invece livelli ben definiti e responsabilità chiare tra di essi.
Livello sorgente e operativo
Questo livello comprende sistemi ERP, CRM, di produzione, di magazzino, di risorse umane, finanziari e operativi specialistici. Questi sistemi supportano le transazioni e dovrebbero rimanere il sistema di riferimento per i dati che sono progettati per gestire. L'architettura deve documentare le fonti autorevoli e definire come vengono acquisite le modifiche senza sovraccaricare inutilmente le operazioni critiche.
Livello di integrazione e trasferimento dati
I dati transitano attraverso API, eventi, pipeline batch, scambi di file e integrazioni di flussi di lavoro. Il modello corretto dipende dal caso d'uso. Lo sblocco di un credito potrebbe richiedere informazioni quasi in tempo reale, mentre la reportistica mensile sulla redditività potrebbe non richiederle. L'architettura dovrebbe standardizzare i metodi di integrazione, la gestione degli errori, la riconciliazione e l'osservabilità, in modo che ogni nuova connessione non si trasformi in un problema di manutenzione personalizzata.
Livello di archiviazione, trasformazione e distribuzione
Questo livello prepara i dati per la reportistica operativa, l'analisi, la pianificazione, l'automazione e l'intelligenza artificiale. A seconda dei requisiti, può includere un data store operativo, un data warehouse, un lakehouse, prodotti dati orientati al dominio o una combinazione di questi. La scelta progettuale fondamentale non è l'etichetta, bensì la capacità dell'organizzazione di fornire dati governati con la velocità, il livello di dettaglio e l'affidabilità richiesti dal caso d'uso aziendale.
La logica di trasformazione deve essere visibile e controllabile. Se ricavi, inventario o stato del cliente vengono calcolati in modo diverso in report differenti, l'architettura non ha risolto il problema di fondo. Una logica di business riutilizzabile e metriche documentate riducono le contraddizioni nei report e accelerano la consegna.
Livello di governance, sicurezza e metadati
La governance non può essere un semplice documento di policy esterno all'architettura. Deve essere integrata nel modo in cui i dati vengono creati, classificati, consultati, modificati e monitorati. Questo livello comprende glossari aziendali, metadati, tracciabilità, accesso basato sui ruoli, requisiti di conservazione, controlli di qualità dei dati, registri di controllo e gestione dei problemi.
I metadati sono particolarmente preziosi perché forniscono ai team il contesto necessario. Un utente di una dashboard deve sapere cosa significa una metrica, da dove proviene e quando è stata aggiornata l'ultima volta. Uno sviluppatore di automazione deve sapere se un campo è stabile e approvato per l'uso. Un data scientist deve capire se i valori storici sono stati rettificati o rimossi. Senza questo contesto, l'accesso a più dati spesso genera maggiore incertezza.
Livello di consumo e decisione
L'architettura dovrebbe supportare i luoghi in cui il lavoro si svolge effettivamente: applicazioni aziendali, dashboard, strumenti di pianificazione, motori di workflow, piattaforme di automazione e servizi di intelligenza artificiale. È qui che l'architettura dimostra il suo valore commerciale.
Un modello ad alte prestazioni non richiede agli utenti di interrompere il proprio flusso di lavoro per cercare informazioni in un ambiente di reporting separato. Fornisce dati gestiti direttamente nel processo, che si tratti di mostrare il punteggio di rischio del cliente durante il rilascio dell'ordine, di instradare un'eccezione del fornitore al responsabile competente o di fornire a un team di assistenza una cronologia completa del caso.
Progettazione della qualità dei dati come controllo operativo
I programmi di qualità dei dati spesso falliscono perché misurano i difetti senza modificare il processo che li genera. Un report mensile che mostri le registrazioni incomplete dei fornitori è utile solo se porta a una chiara individuazione delle responsabilità, alla correzione e alla prevenzione.
Trattate le regole di qualità come controlli operativi. Definite gli elementi di dati critici per ogni processo, come le condizioni di pagamento, la classificazione fiscale, i tempi di consegna dei materiali, lo stato di credito del cliente o le coordinate bancarie. Impostate le soglie in base all'impatto sul business. Un campo di marketing facoltativo mancante non dovrebbe essere considerato con la stessa urgenza di un'istruzione di pagamento non valida.
La gestione della qualità dovrebbe includere quattro pratiche interconnesse:
- Prevenzione tramite campi obbligatori, regole di convalida, flussi di lavoro di approvazione e dati di riferimento controllati.
- Rilevamento tramite profilazione, monitoraggio, riconciliazione e segnalazione delle eccezioni.
- Risoluzione tramite responsabili assegnati, livelli di servizio e flussi di lavoro di ripristino tracciabili.
- Miglioramento tramite analisi delle cause profonde che modifica il processo, la politica o la configurazione del sistema a monte.
Il compromesso è chiaro. Controlli eccessivi possono rallentare il lavoro legittimo, mentre controlli deboli spostano il rischio e le rilavorazioni a valle. Una progettazione corretta applica una convalida più rigorosa ai dati ad alto rischio e utilizza percorsi di eccezione pratici laddove le operazioni aziendali necessitano di flessibilità.
Rendere la governance responsabile e snella
La governance diventa inefficace quando viene trattata come un comitato privo di autorità sulle decisioni quotidiane. Diventa inoltre impopolare quando ogni richiesta di dati richiede un lungo ciclo di approvazione. La soluzione non è ridurre la governance, bensì progettarla attorno a una chiara definizione delle responsabilità e a decisioni ripetibili.
I titolari delle aziende dovrebbero definire il significato, le aspettative di qualità e l'uso accettabile per i propri domini. I responsabili dei dati dovrebbero gestire le definizioni, monitorare i problemi e coordinare le soluzioni. I team tecnologici dovrebbero implementare controlli, modelli di integrazione, sicurezza e gestione della piattaforma. I responsabili dei processi dovrebbero garantire che le regole siano adatte ai flussi di lavoro operativi reali.
Un ufficio centrale per la gestione dei dati può stabilire standard e risolvere conflitti tra domini diversi, ma non dovrebbe diventare il proprietario di ogni singolo set di dati. Le persone più vicine al processo sono generalmente nella posizione migliore per valutare se i dati sono adatti allo scopo. I team centrali forniscono il modello comune, gli strumenti, le garanzie e il percorso di escalation che consentono alla responsabilità locale di operare su scala aziendale.
Progettare per l'automazione e l'intelligenza artificiale senza creare nuovi rischi
L'automazione e l'intelligenza artificiale aumentano il valore di dati puliti e interconnessi, ma mettono anche rapidamente a nudo le fondamenta deboli. Un flusso di lavoro può elaborare migliaia di transazioni con la stessa regola errata. Una soluzione di intelligenza artificiale può generare risultati convincenti basandosi su informazioni obsolete, incomplete o non autorizzate.
L'architettura dovrebbe definire interfacce dati approvate per l'automazione e i casi d'uso dell'IA. Queste interfacce dovrebbero includere schemi documentati, controlli di accesso, verifiche di qualità, tracciabilità e monitoraggio. Per le decisioni ad alto impatto, è opportuno mantenere la revisione umana, registrare i dati di origine utilizzati e stabilire soglie oltre le quali un caso deve essere inoltrato a un livello superiore.
Ciò non significa che ogni caso d'uso richieda lo stesso livello di controllo. Un assistente di intelligenza artificiale generativa che riassume articoli di supporto interni ha un profilo di rischio diverso rispetto a un modello di intelligenza artificiale che raccomanda azioni di pagamento o modifiche alla produzione. Le decisioni architetturali dovrebbero riflettere l'impatto finanziario, operativo, normativo e sul cliente di ciascun caso d'uso.
Trasformare l'architettura in una roadmap di implementazione
Un'architettura di riferimento acquisisce valore quando modifica i risultati di erogazione. Iniziate con un insieme mirato di processi ad alto valore e definite un'architettura minima funzionale attorno ad essi. Stabilite definizioni di dominio comuni, responsabilità, standard di integrazione, controlli di qualità e modelli di consumo. Quindi espandete l'architettura utilizzando le lezioni apprese dall'implementazione.
Misurare i progressi in termini aziendali: meno riconciliazioni manuali, risoluzione più rapida dei casi, minori volumi di eccezioni, cicli di reporting più brevi, elaborazione automatizzata migliorata e minore impegno per lanciare una nuova automazione. Le metriche tecniche come l'affidabilità della pipeline e l'aggiornamento dei dati sono importanti, ma devono supportare i risultati operativi.
Ective affronta questo lavoro come parte di un programma di trasformazione integrato. Riprogettazione dei processi, architettura dei dati, automazione, dashboard e implementazione dell'IA devono rafforzarsi a vicenda. Sviluppare queste capacità separatamente di solito trasferisce la complessità da un team all'altro.
Il passo successivo più utile è selezionare un processo in cui i dati di scarsa qualità abbiano un costo operativo tangibile, quindi tracciare il problema dalla creazione della fonte fino alla decisione o all'automazione. Questo esercizio rivelerà quali decisioni architetturali devono essere prese ora e quali possono attendere fino a quando la loro validità per il business non sarà dimostrata.